实验数据管理:被很多青年研究者忽略的发论文核心密码
前阵子帮一个博士生改论文返修。实验做得漂亮,结果也顶刊,可临了审稿人要原始实验数据,他翻遍了三个硬盘、百度云、甚至旧手机,才把数据凑出来。打开一看,文件夹命名全是“最终版”“真最终版”“绝对不改版”,变量对应错了三个,直接被编辑要求补做半个月实验。
延毕的风险悬在头上,他蹲在我办公室走廊抽烟,说从来没人教过他这个。
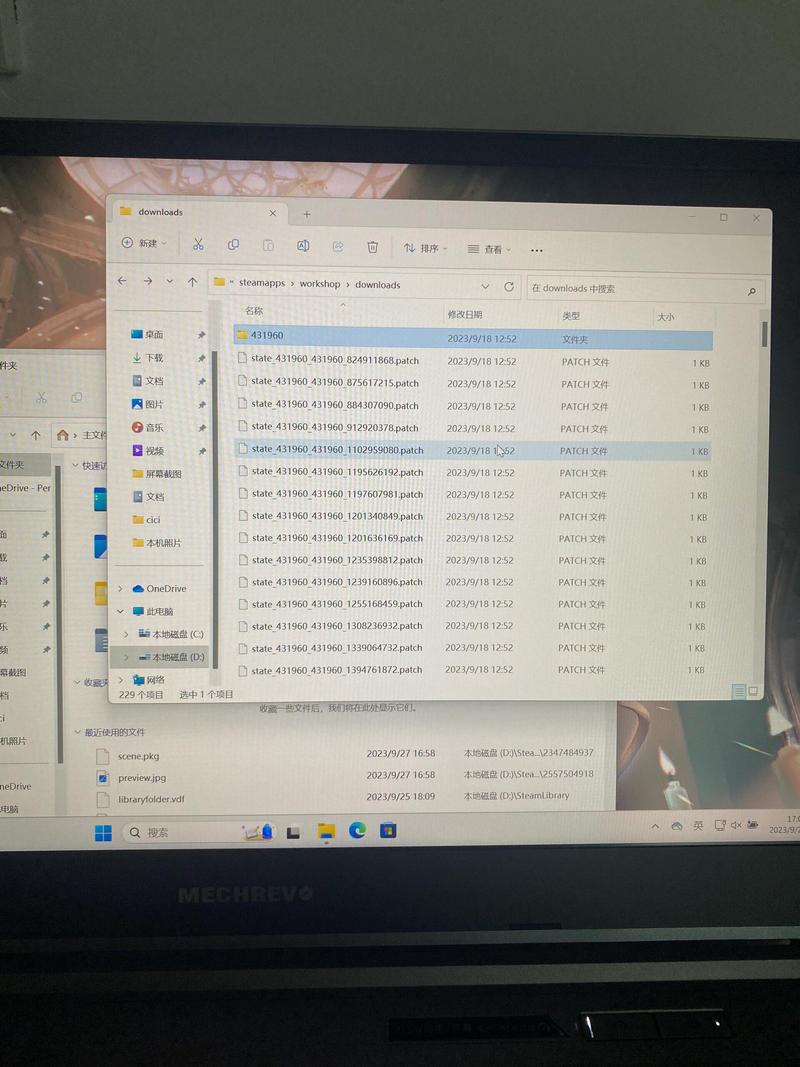 科研实验室混乱命名实验数据文件夹截图
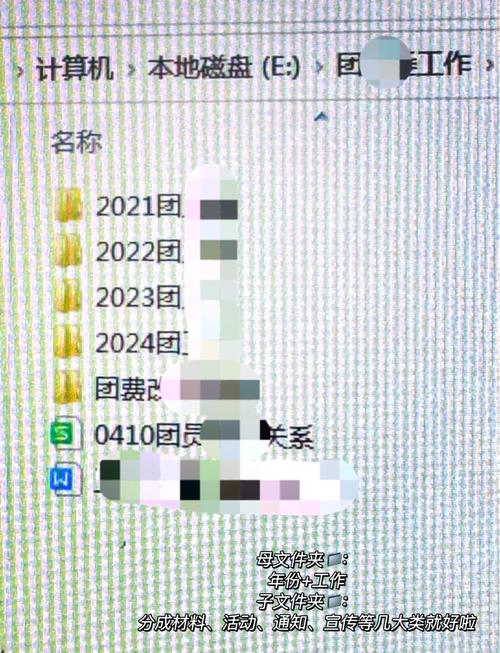 规范命名的生物实验数据管理文件夹列表
不过话说回来,真的有人能每次都记这么细吗?刚开始肯定会忘,养成习惯就好了,花不了你五分钟。总好过你投稿的时候对着一堆乱文件哭,对吧?
 不用买贵价系统,这些免费工具足够用
很多高校现在推企业级的实验数据管理平台,功能全是全,就是太难用,一堆审批流程,很多人嫌麻烦还是用自己的方法。
说实话,普通课题组真没必要花那个钱,我用了快十年的组合,一分钱不花,够好用。
学校给的云盘或者免费的公共云盘,存数据,开个课题组共享文件夹,每个人按自己名字建目录,谁走了数据都留在课题组里,不会带走。别只存在自己的笔记本电脑里,硬盘坏了、电脑丢了的案例我见得太多,有人因此延毕一年,说起来都是泪。
记元数据用Notion或者飞书文档,建个模板,每次做完实验填进去,搜关键词一秒就能找到,比你记在纸质本子上好找一万倍。
整理杂乱的实验数据用OpenRefine,比Excel好用太多,批量改格式、匹配变量,十分钟就能搞定你一下午的活,我逢人就推。
发论文之后,把原始数据传到Zenodo或者Figshare,拿个DOI,既满足期刊的开放数据要求,别人还能引用你的数据,也算额外的学术产出,何乐而不为?
现在国自然申请都要求写清项目的数据管理方案了,你早早把这套流程用熟,写申请书的时候都比别人顺畅,评审一看就知道你是规范做研究的,印象分直接拉满。
很多干实验的朋友说,我们做计算的不用搞这个吧?错了,大错特错。你的测序原始数据、代码版本、参数设置,更要管。换个服务器路径错了,代码跑不出来,找原来的参数找疯了的例子,我身边一抓一大把。
别存侥幸,说什么我脑子好记得住。你做十个实验记得住,做一百个呢?做一千个呢?
我真的见过太多人,实验做了大半年,结果对不上,找原始数据找不到,只能重头再来,大半年时间打了水漂。就是因为一开始嫌麻烦,不肯花那十分钟整理数据。
实验数据管理从来不是什么高大上的玄学,也不是给科研人加的不必要负担,说白了就是给自己留后路。你按规则来,花的那点时间,迟早会在你投稿、评奖、申项目的时候给你赚回来。
反正,吃过亏的人都懂。
为什么现在实验数据管理越来越重要了?
放在十年前,很多人做完实验,数据记在本子上,存在自己电脑里,只要能出结果写论文就行,没人管你原始数据留不留。现在不一样了。 全球顶刊几乎全要求投稿时提供可重复的原始数据,开放获取数据已经是默认规则。国内学术期刊也在跟进,去年起不少核心都明确要求数据可查。再加上现在学术不端核查越来越严,你的数据拿不出来,或者对不上,直接就给你拒稿,甚至撤稿。 还有更坑的。师兄毕业走人,数据存在他自己的电脑里,密码没人知道,硬盘带回家了,师弟师妹接课题,全得从头再来。我知道一个国家级重点实验室,攒了十几年的实验数据,换服务器的时候丢了三分之一,找不回来,整个课题组停了大半年。 说实话,这种事完全可以避免。科研实验室混乱命名实验数据文件夹截图
好的实验数据管理,其实就是几件小事
很多人一听“管理”两个字,就觉得要搞复杂的系统,花很多时间,其实根本不是。你只要从进实验室第一天,把几件小事固定下来,一点都不费时间。 第一件,统一数据命名规则。别瞎起名字,固定格式:「实验日期-处理条件-样本类型-操作者缩写」,比如20240521-5uM顺铂处理-HEK293细胞-LM,任何人打开都能一眼看懂,放三年都不会忘。 第二件,分开存原始数据和分析后数据。原始数据就是你仪器导出来的那堆文件,一丁点都别改,存在专门的文件夹里。分析完的数据另建一个文件夹,别覆盖原始文件。很多人图方便直接改原始数据,改到最后自己都不知道哪版是真的。 第三件,一定要记元数据。什么是元数据?就是你实验里所有没写进数据文件的细节:试剂批号、仪器编号、室温多少、孵育了多久、甚至当天电源跳了一次闸这种小事,都记下来。别相信你的脑子,我敢打赌,三个月后你绝对记不清当时用的是哪批抗体。规范命名的生物实验数据管理文件夹列表
不过话说回来,真的有人能每次都记这么细吗?刚开始肯定会忘,养成习惯就好了,花不了你五分钟。总好过你投稿的时候对着一堆乱文件哭,对吧?
不用买贵价系统,这些免费工具足够用
不用买贵价系统,这些免费工具足够用
很多高校现在推企业级的实验数据管理平台,功能全是全,就是太难用,一堆审批流程,很多人嫌麻烦还是用自己的方法。
说实话,普通课题组真没必要花那个钱,我用了快十年的组合,一分钱不花,够好用。
学校给的云盘或者免费的公共云盘,存数据,开个课题组共享文件夹,每个人按自己名字建目录,谁走了数据都留在课题组里,不会带走。别只存在自己的笔记本电脑里,硬盘坏了、电脑丢了的案例我见得太多,有人因此延毕一年,说起来都是泪。
记元数据用Notion或者飞书文档,建个模板,每次做完实验填进去,搜关键词一秒就能找到,比你记在纸质本子上好找一万倍。
整理杂乱的实验数据用OpenRefine,比Excel好用太多,批量改格式、匹配变量,十分钟就能搞定你一下午的活,我逢人就推。
发论文之后,把原始数据传到Zenodo或者Figshare,拿个DOI,既满足期刊的开放数据要求,别人还能引用你的数据,也算额外的学术产出,何乐而不为?
现在国自然申请都要求写清项目的数据管理方案了,你早早把这套流程用熟,写申请书的时候都比别人顺畅,评审一看就知道你是规范做研究的,印象分直接拉满。
很多干实验的朋友说,我们做计算的不用搞这个吧?错了,大错特错。你的测序原始数据、代码版本、参数设置,更要管。换个服务器路径错了,代码跑不出来,找原来的参数找疯了的例子,我身边一抓一大把。
别存侥幸,说什么我脑子好记得住。你做十个实验记得住,做一百个呢?做一千个呢?
我真的见过太多人,实验做了大半年,结果对不上,找原始数据找不到,只能重头再来,大半年时间打了水漂。就是因为一开始嫌麻烦,不肯花那十分钟整理数据。
实验数据管理从来不是什么高大上的玄学,也不是给科研人加的不必要负担,说白了就是给自己留后路。你按规则来,花的那点时间,迟早会在你投稿、评奖、申项目的时候给你赚回来。
反正,吃过亏的人都懂。