经验教训总结:科研项目踩过的三个大坑,可算是填平了
说实话,上周整理移动硬盘,翻出一个让人头疼的文件夹。那是一年前那场灾难的现场——我们把训练数据清洗了十六遍,最后发现还是漏了最关键的一步。那一刻,像打游戏boss战只剩下1%血量,你却没带蓝药。
科研毕竟不是游戏,但踩坑的滋味比游戏里被秒杀还难受。趁还记得,写点经验教训总结,给自己也给同行。都是血和泪换来的,不掺水。
第一条教训:文献里的完美结果,多半是幸存者偏差
你可能背过这句名言:History is written by the survivors. 放到科研里,文献就是那个“幸存者”。没人愿意把自己失败的十次尝试写在论文里。所以你能看到的,往往是最顺滑的那条曲线,最显著的p值。别天真了。
我们当年想复现一篇顶会论文的算法,硬是折腾了两个月。代码库是公开的,但跑出来的性能就是差一大截。后来发邮件给作者,他才小声说“你需要把学习率调到0.003,另外我们用了额外的集成”。可这些在方法里都没写。你要是照着原文参数跑,跑到天荒地老也复现不出。
这种现象有多普遍?近些年很多团队在做大规模的重复性研究,结果让人心凉。比如《Nature》在2015年做过一个调查,超过70%的科学家承认无法复现他人的实验结果。这不是危言耸听。学会怀疑,是科研的第一课。
那怎么办?我的经验是:第一,仔细看补充材料,找找有没有“手动操作”。第二,直接给作者发邮件,态度诚恳点,大部分人都愿意分享细节。第三,实在不行,你就当那篇文献是“锚点”,别把时间都耗在较劲上。能复现是运气,不能才是常态。
 科研文献可重复性验证流程图
第二条教训:数据管理不是走形式,是你最后的救命稻草
我有个师弟,人很聪明,就是不爱做备份。有一次实验数据存在实验室电脑上,结果硬盘突然坏了。他花了一整个暑假做的模拟,全没了。你能想象他那天的样子吗?——整个人像被抽走了魂。后来我们帮他找回了一部分,但那三个星期的时间,永远找不回来了。
现在很多科研项目都依赖数据。可数据管理这件事吧,确实枯燥,不酷。写代码多帅,做实验多正规,可是整理文件夹、写README、定时备份,这些做起来像个助理。然而,没有这些“助理”干的活,你的科研迟早要栽跟头。
我自己的原则是:原始数据只读,中间数据可存,最终数据多备份。别把鸡蛋放一个篮子里,服务器上存一份,网盘存一份,移动硬盘再存一份。别看老土,关键时刻能救命。
还有啊,现在的趋势是,期刊开始要求数据可用性声明。很多高水平杂志强制你上传原始数据。如果你没养成好习惯,到那一步只能临时抱佛脚,那叫一个狼狈。早点理顺数据管理,其实就是给自己的未来买保险。
对了,电子实验记录本真的很香。我以前觉得手写更有温度,直到有一次需要翻三个月前在笔记本上记的一个参数,我翻了半天,最后发现那页被咖啡渍糊住了。现在用Markdown+Git,几秒钟就能定位。科技的力量,就是拿来解这种痛的。
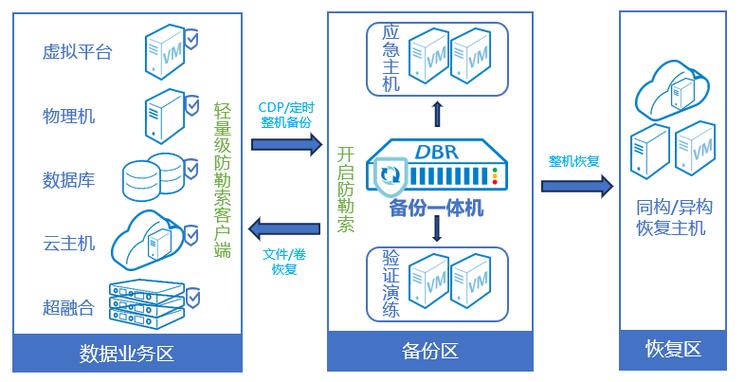 科研数据备份方案示意图
第三条教训:科研的终点不是论文,而是解决问题
 第三条教训:科研的终点不是论文,而是解决问题
去年参加一个产学研对接会,有个做农业物联网的老板跟我聊。他看了我们的论文,说里边的东西他们完全用不上——因为我们的模型准确率虽高,但需要一台GPU服务器,而他们的设备只有树莓派。他一句话让我哑口无言:“你做的这玩意儿,我们装哪?”
这话伤人,但真实。科研界过去太看重发论文了,大家比谁的影响因子高,引用多,却很少有人问一句:这研究成果,到底帮到谁了?现在风向已经在变,国家政策在推“破唯论文”,强调科技成果转化。可事实上,转化率依然不算高。
我自己的反思是:选题阶段就要想着应用。哪怕你是做基础理论,也可以去想象未来的场景。比如你发现一个新的化学催化机制,那它能不能降低某个工业流程的成本?如果你研究一个心理学模型,它能不能用来改进在线教育?听起来有点远,但多想一想,你的研究会更有生命。
还有一点,学会跟企业里的人打交道。他们有时候提需求,你觉得“不够学术”,但正是那种接地气的“够用就行”,逼着你重新审视自己的技术。别把合作当成抱怨的对象,那其实是免费的“需求分析报告”。
现在很多高校开始设“应用数学”和“工程博士”,不就是这个道理吗?让科研成果长在祖国的大地上——这话可能有点喊口号,但真的不空。
好了,这就是我目前最想说的三条经验教训。踩过坑,才知道路该怎么修。科研是一场马拉松,犯过的错都是路标。愿你少走弯路,多出成果。