技术组合优化:从玄学到科学的深度实践
说实话,刚看到“技术组合优化”这五个字的时候,我脑子里最先蹦出来的是“组合盆栽”或者“优化理发套餐”这类不靠谱的画面。搞技术的人就爱造这种词——听着很高深,实际上有时候就是纸老虎。但后来我自己在项目里被调参折磨得死去活来,某天突然发现,这玩意儿还真不是吹的。
说白了,技术组合优化就是在多个技术变量里找到最合适的那个组合。比如机器学习里,你既要用随机森林还是深度学习?学习率设多少?Batch size调多少?特征要不要做PCA?这些单个拿出来都不算难,可一旦组合起来,可能性空间比你头顶上的头发还多。
那时候我负责一个推荐系统的CTR预估模型。调参调了差不多两周,从网格搜索到随机搜索,能试的都试了,结果始终卡在AUC 0.74上不去。每天看着训练曲线,感觉自己在跟玄学对线——明明已经调了好几天,损失函数就是不下去,我真是想摔键盘。
后来一个路过的大四实习生对我说:“为什么不用贝叶斯优化?你这根本就是个技术组合优化问题啊。”我当场愣住了。原来,我一直在手动调,本质上就是在做一个低维组合优化,只不过我用的是最笨的穷举法。正经的科研论文里,这种问题早就有成熟的解决框架了。
好吧,现在正式聊正题。
## 一、技术组合优化到底在干嘛?
它本质上就是用更小的试错代价,去逼近一个高维函数的最优参数组合。这概念其实不新,上世纪五六十年代,实验设计(Design of Experiment)就是干这行的。但和古老的试验设计相比,现在的技术组合优化更强调海量变量和自动化搜索,尤其是机器学习、材料科学、药物研发这种动不动就出现上万个变量组合的领域。
举个例子,你有一台蒸镀仪,要沉积一种多组分氧化物薄膜。每个组分有三个不同的比例,总共6个组分,那组合数就是3的6次方等于729种。你一天跑一个配方,得跑两年。而利用组合合成和高通量表征,一次就能沉积100种不同配比的薄膜,然后再用机器学习去分析哪些组分组合能带来目标性能。这简直就是给材料研究开了挂。
再说一个更贴近算法圈的。我以前总觉得参数搜索嘛,网格搜索就行。后来才明白,网格搜索在二维三维空间还行,参数一多,简直是爆炸。随机搜索稍好一点,但它没有记忆,全凭运气。贝叶斯优化就不一样了,它会把已经试过的点都记下来,构建一个代理模型,然后根据代理模型的均值和方差,找既有潜力又还没探索够的区域去试验。就像一个有经验的猎手,不是瞎跑,是循着脚印走的。
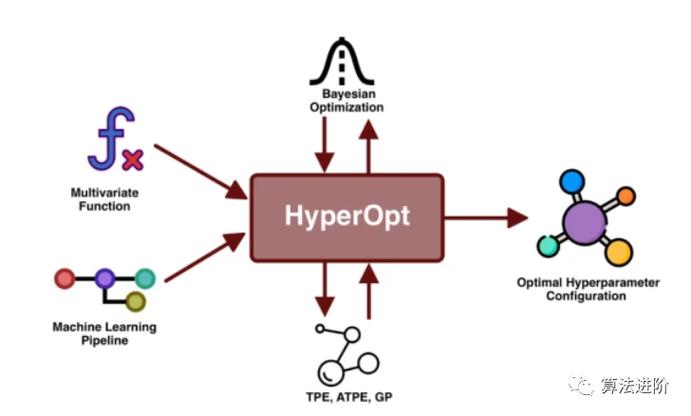 贝叶斯优化超参数搜索过程示意图
所以,技术组合优化严格来说不是一种“方法”,而是一种“方法论”。它把你要调的技术参数、工艺步骤、材料配方,全都当成变量,然后用一套搜索策略,在庞大的组合空间里找那个最优解。这中间的学问比你想象的大得多。
## 二、一个身边的例子:从科研到工业
可能你觉得材料科学离得太远。那我说个最近的——互联网广告投放中的参数组合优化。
很多公司的广告系统里有几十个可调参数:出价系数、预算分配、人群定向权重、创意轮换频率……这些参数互相影响。你以为把出价提高10%就能多拿量?结果预算上限卡在那就等于没提。这就是典型的非线性组合效应。我朋友在某大厂做广告策略优化,他们最初就是人工调参,每周调一次,调来调去还是那几套组合。后来引入了贝叶斯优化加多目标进化算法,每天自动跑几百次实验,ROI提升了不少。你问这跟技术组合优化有什么关系?关系大了——他们做的事情就是把广告策略参数当成变量,用优化算法去寻找那个让成本和ROI都让人满意的组合,跟调材料配方完全是一回事。
说到工业界,科研界其实早就有了一个分支叫AutoML,自动机器学习。你只需要把数据丢进去,它自动组合特征工程、模型选择、超参数优化。像Auto-sklearn、TPOT这些框架,都能在几小时内给你一个不错的基线模型。说实话,我以前挺抵触的,毕竟这玩意儿有点“抢饭碗”的意思。直到有一回为了赶一个Kaggle比赛,我实在没时间手调,就丢给TPOT跑了一个晚上。第二天早上拿到结果的时候,我差点把咖啡喷出来——它找到的模型结构我自己调了一个星期都没调出来。确实服气。
 AutoML特征工程与超参数组合优化流程图
顺便说一句,现在很多人都把技术组合优化和“调参”划等号,其实很片面。调参只是它的一个缩影。在制造领域,它可以是铣削参数的速度、进给量、切削深度的组合;在药物研发里,它可以是不同基团、不同溶剂、不同催化剂分子的组合。这套底层逻辑,放到哪儿都成立。
## 三、落地时最容易踩的坑
讲了半天好处,但技术组合优化可不是万能神药。我自己踩过不少坑,整理一下给大家避避雷。
第一个坑:搜索空间定义得太大。新手容易把所有参数一股脑全丢进去,结果搜索空间大得离谱,即便用上贝叶斯优化,也要跑出银河系了。我的建议是,先做特征重要性分析,或者用上一轮的经验,把无关变量固定住,只对真正关键的3~5个参数做组合优化。比如我们之前调Transformer模型,学习率、batch size、层数、多头数、dropout,如果全调,组合数根本没法承受。后来先固定层数和多头数,只调学习率和batch size,效果反而很快上来了。
第二个坑:用错了评估方法。组合优化的每一步都需要一个评价指标,但如果你用一小批验证集来评估,很容易被噪声带偏。这时候一定要用交叉验证,或者至少用分层抽样保持数据分布稳定。我一开始就吃过这个亏——优化算法在一堆局部波动的指标里来回摇摆,最后收敛到了一个假的“最优解”。等换到测试集上,效果比随机搜索还差。气得我当场把模型文件夹删了。
第三个坑:优化目标跟业务目标不一致。我们做技术组合优化,优化的是某个技术指标,但如果这个指标和最终业务目标没有强关联,那你优化出来的组合就是“纸面华丽,实际拉胯”。比如广告点击率可能上去了,但转化率没变,甚至可能因为虚假点击导致成本飙升。这种情况下,你得考虑多目标优化,或者把业务指标纳入约束条件。
第四个坑:忽略现实约束条件。很多组合优化问题是有生产实际约束的,比如材料制备温度不能超过多少度,某些参数组合不能同时成立。这些约束如果不写进优化目标,算法就会给你一个理论上完美但实际没法用的解。我们之前做电池材料,优化出来的配方能量密度超高,但需要1200度的高温烧结,产线上根本做不到。后来只能把温度、压力等作为硬性约束重新优化,才勉强可用。
所以说,技术组合优化不是一个交付完就能跑的工具,它需要你不断地质疑你定义的搜索空间、评估指标和约束条件。现在有很多新的研究方向,比如多目标优化、带安全约束的贝叶斯优化、联邦学习下的分布式组合优化等等,但万变不离其宗——你得先把问题定义清楚。
作为过来人,我最大的体会就是:技术组合优化的核心不是算法本身,而是你对问题的理解和建模能力。如果你连哪些变量重要、哪些约束不能打破都没搞清,再牛的优化器也救不了你。反过来,如果你能定义好问题,哪怕用最简单的随机搜索,也可能得到意想不到的好结果。
最后,不管你是搞科研还是搞工程,遇到多个参数纠缠不清的时候,真的,先别急着拍脑袋。试试把技术组合优化这套思路用起来——你可能会发现,原来“调参玄学”也可以变成科学。虽然这过程还是有点费头发,但至少是值得的。
好了,就扯到这里吧。我得去改bug了。
贝叶斯优化超参数搜索过程示意图
所以,技术组合优化严格来说不是一种“方法”,而是一种“方法论”。它把你要调的技术参数、工艺步骤、材料配方,全都当成变量,然后用一套搜索策略,在庞大的组合空间里找那个最优解。这中间的学问比你想象的大得多。
## 二、一个身边的例子:从科研到工业
可能你觉得材料科学离得太远。那我说个最近的——互联网广告投放中的参数组合优化。
很多公司的广告系统里有几十个可调参数:出价系数、预算分配、人群定向权重、创意轮换频率……这些参数互相影响。你以为把出价提高10%就能多拿量?结果预算上限卡在那就等于没提。这就是典型的非线性组合效应。我朋友在某大厂做广告策略优化,他们最初就是人工调参,每周调一次,调来调去还是那几套组合。后来引入了贝叶斯优化加多目标进化算法,每天自动跑几百次实验,ROI提升了不少。你问这跟技术组合优化有什么关系?关系大了——他们做的事情就是把广告策略参数当成变量,用优化算法去寻找那个让成本和ROI都让人满意的组合,跟调材料配方完全是一回事。
说到工业界,科研界其实早就有了一个分支叫AutoML,自动机器学习。你只需要把数据丢进去,它自动组合特征工程、模型选择、超参数优化。像Auto-sklearn、TPOT这些框架,都能在几小时内给你一个不错的基线模型。说实话,我以前挺抵触的,毕竟这玩意儿有点“抢饭碗”的意思。直到有一回为了赶一个Kaggle比赛,我实在没时间手调,就丢给TPOT跑了一个晚上。第二天早上拿到结果的时候,我差点把咖啡喷出来——它找到的模型结构我自己调了一个星期都没调出来。确实服气。
AutoML特征工程与超参数组合优化流程图
顺便说一句,现在很多人都把技术组合优化和“调参”划等号,其实很片面。调参只是它的一个缩影。在制造领域,它可以是铣削参数的速度、进给量、切削深度的组合;在药物研发里,它可以是不同基团、不同溶剂、不同催化剂分子的组合。这套底层逻辑,放到哪儿都成立。
## 三、落地时最容易踩的坑
讲了半天好处,但技术组合优化可不是万能神药。我自己踩过不少坑,整理一下给大家避避雷。
第一个坑:搜索空间定义得太大。新手容易把所有参数一股脑全丢进去,结果搜索空间大得离谱,即便用上贝叶斯优化,也要跑出银河系了。我的建议是,先做特征重要性分析,或者用上一轮的经验,把无关变量固定住,只对真正关键的3~5个参数做组合优化。比如我们之前调Transformer模型,学习率、batch size、层数、多头数、dropout,如果全调,组合数根本没法承受。后来先固定层数和多头数,只调学习率和batch size,效果反而很快上来了。
第二个坑:用错了评估方法。组合优化的每一步都需要一个评价指标,但如果你用一小批验证集来评估,很容易被噪声带偏。这时候一定要用交叉验证,或者至少用分层抽样保持数据分布稳定。我一开始就吃过这个亏——优化算法在一堆局部波动的指标里来回摇摆,最后收敛到了一个假的“最优解”。等换到测试集上,效果比随机搜索还差。气得我当场把模型文件夹删了。
第三个坑:优化目标跟业务目标不一致。我们做技术组合优化,优化的是某个技术指标,但如果这个指标和最终业务目标没有强关联,那你优化出来的组合就是“纸面华丽,实际拉胯”。比如广告点击率可能上去了,但转化率没变,甚至可能因为虚假点击导致成本飙升。这种情况下,你得考虑多目标优化,或者把业务指标纳入约束条件。
第四个坑:忽略现实约束条件。很多组合优化问题是有生产实际约束的,比如材料制备温度不能超过多少度,某些参数组合不能同时成立。这些约束如果不写进优化目标,算法就会给你一个理论上完美但实际没法用的解。我们之前做电池材料,优化出来的配方能量密度超高,但需要1200度的高温烧结,产线上根本做不到。后来只能把温度、压力等作为硬性约束重新优化,才勉强可用。
所以说,技术组合优化不是一个交付完就能跑的工具,它需要你不断地质疑你定义的搜索空间、评估指标和约束条件。现在有很多新的研究方向,比如多目标优化、带安全约束的贝叶斯优化、联邦学习下的分布式组合优化等等,但万变不离其宗——你得先把问题定义清楚。
作为过来人,我最大的体会就是:技术组合优化的核心不是算法本身,而是你对问题的理解和建模能力。如果你连哪些变量重要、哪些约束不能打破都没搞清,再牛的优化器也救不了你。反过来,如果你能定义好问题,哪怕用最简单的随机搜索,也可能得到意想不到的好结果。
最后,不管你是搞科研还是搞工程,遇到多个参数纠缠不清的时候,真的,先别急着拍脑袋。试试把技术组合优化这套思路用起来——你可能会发现,原来“调参玄学”也可以变成科学。虽然这过程还是有点费头发,但至少是值得的。
好了,就扯到这里吧。我得去改bug了。