灾备技术方案别乱选,我用半夜被骂的教训给你捋一捋
上个月一个做跨境电商的老铁半夜打电话把我弄醒,说机房断电了,数据库分不清是死是活。我第一反应是备份呢?他特别骄傲地说,备了,每天一本磁带。我说磁带在哪?他支支吾吾说就放机房角落。我当时差点把手机扔出去——你把备份放生产环境旁边,万一着火了,那不就一起升天?这哪叫灾备,这纯粹是给自己买了个心理安慰。
先搞明白你真正要防的是什么
 先搞明白你真正要防的是什么
很多人一提灾备就想到磁带、异地仓库、拿U盘拷了跑。这套东西……怎么说呢,太老了。现在的业务宕机十分钟,客户就跑去隔壁家了。你说你备份做得再密,恢复要十几个小时,那跟死一回有啥区别?
所以你得先算两个数字:RTO(恢复时间)和RPO(能丢多少数据)。这两个数定不下来,后面全是拍脑袋。我们见过一个老头,非说RPO要为零,然后不愿意花一分钱,总觉得厂家在骗他。你说这咋办?
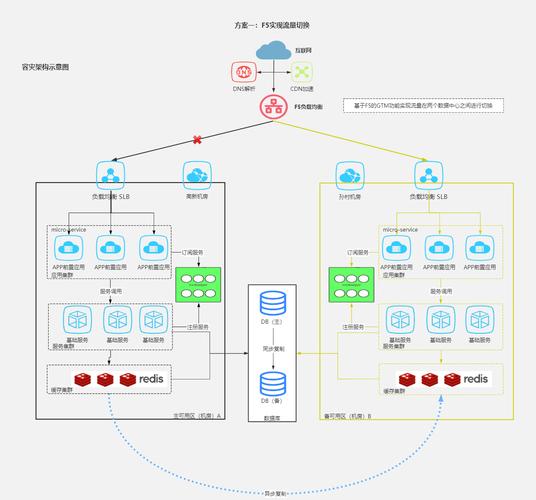
[IMG_灾备机房双活数据中心架构示意图]说实话,我走访过不少企业,聊起来都说“我们做了灾备”。结果一演练,连怎么把VIP切换到灾备站点都搞不懂。有一次演练,DBA临时请假,没人知道数据库的超级口令。整个下午就在那儿干等。之后全公司再也不敢提“演练”这俩字儿。
市面上主流的灾备技术方案,其实就三刀
 市面上主流的灾备技术方案,其实就三刀
第一刀,数据级容灾。就是通过异步复制或者定期增量备份,把数据搬到另一个地方去。成本是真低,但RPO可能做到小时级,甚至更惨。适合那些丢几小时数据还能营业的,比如个人网盘、公开资讯站。
第二刀,应用级容灾。把整个应用组复制到灾备机房,加个心跳检测,生产挂了自动拉起。听起来挺美,但这里面的坑比芝麻多。配置漂移、网络切换、存储LUN映射错位,随便碰一个都够你喝一壶。我们遇到过一个客户,应用起来了,结果生产库和灾备库的序列号没有对齐,主键冲突哗哗的,几万条脏数据直接入库。后来那IT总监被老板骂得狗血淋头。
第三刀,双活甚至多活。这是最烧钱也最带劲的方案。两个机房同时在跑,任何一个节点挂了,另一边无缝接管。很多金融大牛都在吹这个。但你要知道,双活最怕脑裂。网络一抖,两边都以为对方挂了,抢着写数据,最后数据乱成一锅粥。还得靠仲裁机制、规则算法把其中一个打晕。玩不转的话,就别轻易上头。
别迷信工具,流程才最要命
 别迷信工具,流程才最要命
我见过太多公司,把VMware的SRM或者磁盘阵列的复制功能一开,就宣布灾备交付了。兄弟,你的操作手册呢?谁能启动切换?谁负责对外通知?平时多久做一次切换测试?这些一问三不知。
灾备方案从来不是买了个软件装上就完事。真正的核心是组织流程和应急响应机制。去年有个金融机构,技术方案绝对合规,结果真到演练那天,负责拉闸的大哥休年假去了。找来他媳妇,又不记得指纹密码。最后折腾了一个半小时,全公司看着大屏幕上那个进度条卡在18%。这种事儿,写剧本都不敢这么写,但现实就这么残酷。
说到演练,我最烦那种拿一张“演练通过”的报告糊弄老板的。你倒是真刀真枪切一下啊!怕业务中断?怕没周末?那你还做灾备干嘛,不如直接给老板发封邮件说“我们很安全,除了真的出事的时候”。
上云还是自建?这不是个二选一
 上云还是自建?这不是个二选一
现在云上灾备便宜又省心,但如果你还在用Oracle、MySQL这种传统数据库,上云之后可能还得面对主键冲突、序列号重复、时间对不上这些破事。我建议你听听这个思路:异构多站点。本地摆一套,云上放一套,中间用加密通道实时同步。但注意,别太迷信云厂商的POC报告,那都是拿自己的数据跑出来的。你自己拿生产环境的子集压一下,看看性能是不是能扛得住。
[IMG_公有云灾备拓扑图与云存储同步链路示意]还有,现在很多新项目直接上了K8s和容器。但容器化的灾备还真不是光把镜像拉过来就行,持久化数据、编排配置、网络策略都得跟着走。很多初创公司以为容器天生会容灾,天真得让人心疼。容器重启你倒是容易,但里面的数据呢?
一些实在的细节,你不妨记一笔
别嫌我啰嗦,这些东西都是拿血泪换的:
- 备份存储要跟生产物理隔离。别把备份盘挂在同一个SAN上,雷劈都劈一对。
- 加密的密钥要单独放。灾备机房的密管系统被人拿到,那你就是直接把家门钥匙送到小偷手里。
- 定期做恢复演练,哪怕一个月一次。别怕麻烦,别怕花时间。真正出事的时候,你才明白演练的那点成本,连停机损失的零头都算不上。
- 随时关注数据增量变化。很多灾备系统一开始好好的,跑半年之后发现复制延迟越来越大,因为你把日志文件放同一块盘上了。
好了,半夜写这么多,手也酸了。最后说一句实在的:灾备这活儿,平时看不见摸不着,