技术共享机制:打破实验室围墙的野路子
前段时间,我被一个模型卡了整整两周。就是那种,你感觉答案就在手边,但每次跑出来的结果都差那么一口气——准确率不上不下,调参调到头秃。组里没人做过这个方向,导师也只能摊手。直到有天半夜,我刷到一篇论文的补充材料,里面附了 GitHub 链接。点开一看,嚯,那仓库里连文档都没有,就是一堆脚本,夹杂着作者随手写的 # 注意这里可能会报错,懒得改了 的注释。但正是那几行脏兮兮的代码,让我一下子通了。实话实说,那一刻,我对这种野生技术共享充满了感激。
其实想想,科研圈里这种事儿挺常见的。我们天天喊着要开放科学,要打破数据壁垒,可实际上,很多实验室还在把代码当成传家宝。为什么呢?因为大家害怕——怕被抢先发表,怕自己的 bug 被人抓住把柄,怕那点来之不易的竞争力瞬间蒸发。但与此同时,又有一群人在默默往 GitHub 上丢东西,在预印本平台贴原始数据,在论坛里回答那些没人关注的技术问题。这种分裂感,说实话,很魔幻。
过去几年,AI 领域给了我们一堆生动的例子。2018 年,DeepMind 推出 AlphaFold,那蛋白质结构预测的准确率,简直让做结构生物学的同行们后背发凉。可一开始,他们只丢出一篇论文,代码呢?藏着。全球的研究者一边惊叹,一边吐槽:不放出代码,我们怎么验证?怎么复用?直到后来开源了 AlphaFold2,整个领域瞬间爆炸——基于它出现了几百个衍生物,从蛋白设计到药物发现,甚至有人拿它来研究酿酒的酶。所以你看,共享机制一旦启动,它产生的连锁反应远远超出原创团队的想象。不是那种“我给了你,我就少了”的零和博弈,而是大家一起把蛋糕做大的故事。
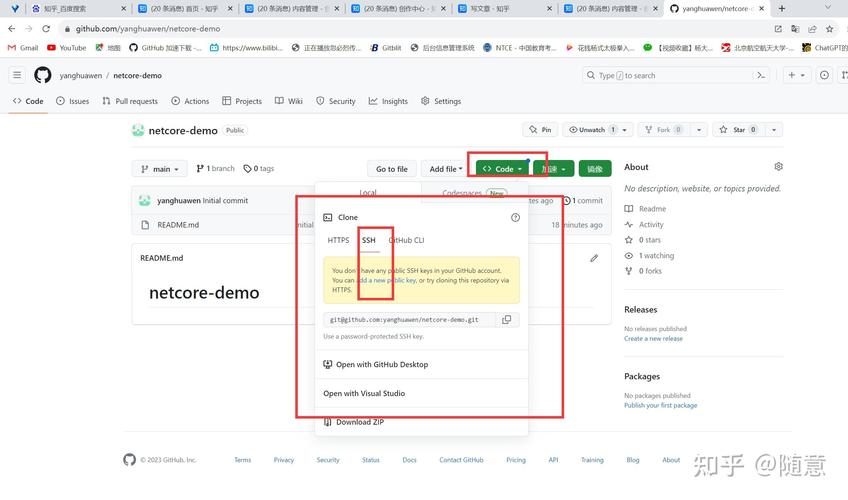 开源代码协作平台GitHub仓库截图
但别误会,共享不等于乱扔。有些项目,代码公开了,但缺乏注释、环境配置极其严苛,跑通一次要折腾好几天。这其实是一种隐性的门槛——表面上开放了,实际只有内行才能用。真正的技术共享机制,需要文档、教程、甚至一些预训练权重的配合。今年 Meta 放出的 Llama 2,虽然被诟病不是“完全开放”,但它配备了详尽的技术报告和社区许可,让不少中小团队能快速上手微调,这比单纯丢个模型权重有用多了。我加入的一个开源社区里,有个哥们儿专门给这些大模型做量化压缩,让它们能在笔记本上跑起来。他跟我说,他的动力很简单——“我想让买不起 A100 的人也能玩。”你看,这就是最朴素的技术共享吧。
 国内的转变:从“关系交换”到平台化协作
以前在国内做科研,想搞点跨界合作,基本靠人情。你认识某所的师兄,他知道某台机器的密码,你才能摸着石头过河。现在不一样了。2019 年以来,国家超算中心、各大云厂商开始搭建各种开放创新平台,比如鹏城实验室的“鹏城云脑”,就把算力和数据共享给高校和中小企业。我上次申请了一个时段,用来跑分子动力学模拟,全程线上搞定,比求人办事高效多了。不过话说回来,这些平台虽然便利,但审核流程有时候让人抓狂——提交预案、等待审批、排队,等排到了,灵感早跑光了。所以你看,体制化的共享机制也需要迭代,需要更灵活,更贴近科研那种随机爆发的节奏。
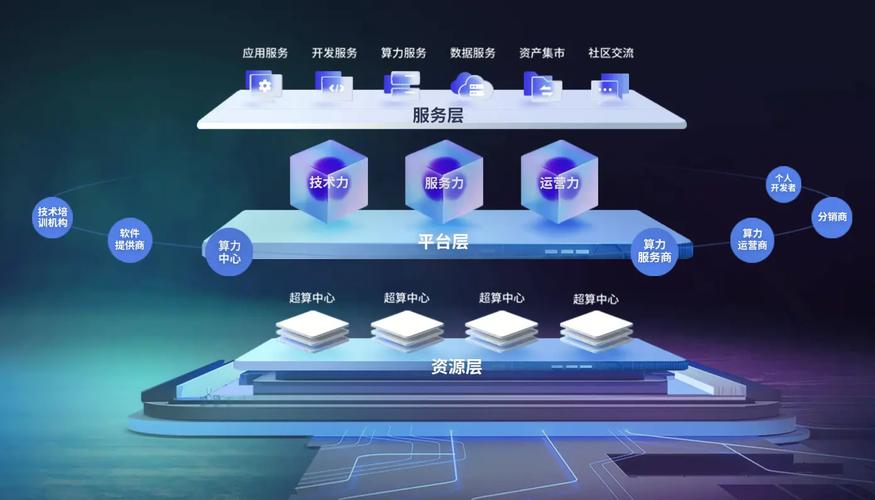 国家超级计算中心开放共享平台界面
还有一种共享形式,是行业联盟。比如中国的“类脑计算技术联盟”,汇集了高校、企业和医院,定期分享数据库和算法基准。这类机制的妙处在于,它解决了“鸡生蛋”的问题:单个机构的数据量不足以训练可靠模型,但大家谁都不愿先交出数据——怕隐私,怕吃亏。通过联盟的协议,数据不动模型动,或者用联邦学习的方式,各方都保留自己的肉,但能一起炖汤喝。我参与过一次跨院的眼底影像分析,每家医院的数据格式都不一样,清洗对齐花了大半年,但最后模型对糖尿病视网膜病变的识别率,比任何单一医院的数据训出来的都高出一大截。那一刻,真的,你会觉得技术共享不是口号——是实实在在的战斗力。
共享机制也绝不是乌托邦。现实中坑太多了。我曾经把一个改进的算法开源,有人在下面 issue 里问怎么用,我耐心回答了;过了一个月,我发现这哥们儿直接拿它改了个皮毛,投了篇会议论文,致谢里连我名字都不提。气愤吗?当然。后来想通了——开源协议这东西,你选了 MIT 或 Apache 2.0,就不能完全阻止别人心术不正。更麻烦的是产权纠纷:合作前谈得好好的成果共享,最后论文发出来,署名顺序能吵翻天。我的导师有句糙话:“共享的前提,是签协议时要假定对方是坏人。”虽然偏激,但真的管用。
还有一个更隐蔽的问题:烂尾。很多开源项目,初始版本风华正茂,star 蹭蹭涨,但作者毕业、跳槽或丧失热情后,就再也没有更新。后来的人用不了,Issue 没人回,变成技术废墟。这种死亡项目,反而成了新人的绊脚石。所以成熟的共享机制,应该考虑可持续性——有没有维护基金?有没有接棒机制?这些在国外一些基金会(比如 Linux 基金会、Apache 基金会)已经有模式了,但国内还比较少见。
 科研合作数据共享平台登陆页设计
不过话说回来,尽管有这些破事,我还是愿意把自己的数据、代码尽量开放。因为闭门造车,实在太慢了。去年在合成生物学领域,有个团队公开了一套用于基因回路设计的标准化元件库,连带着十几页的湿实验记录。我师弟直接拿过来,避开了我们原来要做的三个月预实验,直接进入验证阶段。这种冲击,体会过的人都知道——原来科研可以不用从钻木取火开始。这就是技术共享机制的魔力,它让知识流动的速度,终于跟上了我们思考的速度。虽然多数时候,它依然带着野生、粗糙、不完美的气质,但它正在改变实验室的生存法则。
所以下次再遇到那种只有一个 README.md 的仓库时,先别急着骂。说不定,里面就藏着你找了三个月的解药。
其实想想,科研圈里这种事儿挺常见的。我们天天喊着要开放科学,要打破数据壁垒,可实际上,很多实验室还在把代码当成传家宝。为什么呢?因为大家害怕——怕被抢先发表,怕自己的 bug 被人抓住把柄,怕那点来之不易的竞争力瞬间蒸发。但与此同时,又有一群人在默默往 GitHub 上丢东西,在预印本平台贴原始数据,在论坛里回答那些没人关注的技术问题。这种分裂感,说实话,很魔幻。
开源代码不是做慈善,是一种生存策略
过去几年,AI 领域给了我们一堆生动的例子。2018 年,DeepMind 推出 AlphaFold,那蛋白质结构预测的准确率,简直让做结构生物学的同行们后背发凉。可一开始,他们只丢出一篇论文,代码呢?藏着。全球的研究者一边惊叹,一边吐槽:不放出代码,我们怎么验证?怎么复用?直到后来开源了 AlphaFold2,整个领域瞬间爆炸——基于它出现了几百个衍生物,从蛋白设计到药物发现,甚至有人拿它来研究酿酒的酶。所以你看,共享机制一旦启动,它产生的连锁反应远远超出原创团队的想象。不是那种“我给了你,我就少了”的零和博弈,而是大家一起把蛋糕做大的故事。
开源代码协作平台GitHub仓库截图
但别误会,共享不等于乱扔。有些项目,代码公开了,但缺乏注释、环境配置极其严苛,跑通一次要折腾好几天。这其实是一种隐性的门槛——表面上开放了,实际只有内行才能用。真正的技术共享机制,需要文档、教程、甚至一些预训练权重的配合。今年 Meta 放出的 Llama 2,虽然被诟病不是“完全开放”,但它配备了详尽的技术报告和社区许可,让不少中小团队能快速上手微调,这比单纯丢个模型权重有用多了。我加入的一个开源社区里,有个哥们儿专门给这些大模型做量化压缩,让它们能在笔记本上跑起来。他跟我说,他的动力很简单——“我想让买不起 A100 的人也能玩。”你看,这就是最朴素的技术共享吧。
国内的转变:从“关系交换”到平台化协作
国内的转变:从“关系交换”到平台化协作
以前在国内做科研,想搞点跨界合作,基本靠人情。你认识某所的师兄,他知道某台机器的密码,你才能摸着石头过河。现在不一样了。2019 年以来,国家超算中心、各大云厂商开始搭建各种开放创新平台,比如鹏城实验室的“鹏城云脑”,就把算力和数据共享给高校和中小企业。我上次申请了一个时段,用来跑分子动力学模拟,全程线上搞定,比求人办事高效多了。不过话说回来,这些平台虽然便利,但审核流程有时候让人抓狂——提交预案、等待审批、排队,等排到了,灵感早跑光了。所以你看,体制化的共享机制也需要迭代,需要更灵活,更贴近科研那种随机爆发的节奏。
国家超级计算中心开放共享平台界面
还有一种共享形式,是行业联盟。比如中国的“类脑计算技术联盟”,汇集了高校、企业和医院,定期分享数据库和算法基准。这类机制的妙处在于,它解决了“鸡生蛋”的问题:单个机构的数据量不足以训练可靠模型,但大家谁都不愿先交出数据——怕隐私,怕吃亏。通过联盟的协议,数据不动模型动,或者用联邦学习的方式,各方都保留自己的肉,但能一起炖汤喝。我参与过一次跨院的眼底影像分析,每家医院的数据格式都不一样,清洗对齐花了大半年,但最后模型对糖尿病视网膜病变的识别率,比任何单一医院的数据训出来的都高出一大截。那一刻,真的,你会觉得技术共享不是口号——是实实在在的战斗力。
共享的阴暗面:被占便宜、产权纠纷与烂尾楼
共享机制也绝不是乌托邦。现实中坑太多了。我曾经把一个改进的算法开源,有人在下面 issue 里问怎么用,我耐心回答了;过了一个月,我发现这哥们儿直接拿它改了个皮毛,投了篇会议论文,致谢里连我名字都不提。气愤吗?当然。后来想通了——开源协议这东西,你选了 MIT 或 Apache 2.0,就不能完全阻止别人心术不正。更麻烦的是产权纠纷:合作前谈得好好的成果共享,最后论文发出来,署名顺序能吵翻天。我的导师有句糙话:“共享的前提,是签协议时要假定对方是坏人。”虽然偏激,但真的管用。
还有一个更隐蔽的问题:烂尾。很多开源项目,初始版本风华正茂,star 蹭蹭涨,但作者毕业、跳槽或丧失热情后,就再也没有更新。后来的人用不了,Issue 没人回,变成技术废墟。这种死亡项目,反而成了新人的绊脚石。所以成熟的共享机制,应该考虑可持续性——有没有维护基金?有没有接棒机制?这些在国外一些基金会(比如 Linux 基金会、Apache 基金会)已经有模式了,但国内还比较少见。
科研合作数据共享平台登陆页设计
不过话说回来,尽管有这些破事,我还是愿意把自己的数据、代码尽量开放。因为闭门造车,实在太慢了。去年在合成生物学领域,有个团队公开了一套用于基因回路设计的标准化元件库,连带着十几页的湿实验记录。我师弟直接拿过来,避开了我们原来要做的三个月预实验,直接进入验证阶段。这种冲击,体会过的人都知道——原来科研可以不用从钻木取火开始。这就是技术共享机制的魔力,它让知识流动的速度,终于跟上了我们思考的速度。虽然多数时候,它依然带着野生、粗糙、不完美的气质,但它正在改变实验室的生存法则。
所以下次再遇到那种只有一个 README.md 的仓库时,先别急着骂。说不定,里面就藏着你找了三个月的解药。