保障性技术到底在保什么?——从一次半夜宕机聊起
一次惊心动魄的凌晨三点
 一次惊心动魄的凌晨三点
凌晨三点,手机狂震。群里炸了锅——核心服务挂了,整个交易链路中断。那感觉,就像是深夜急诊,心跳直奔120。说实话,那晚我一点没慌——才怪。手忙脚乱查监控,重启,回滚,一通操作猛如虎,总算在黎明前把服务捞回来。事后复盘,才发现是配置中心一个看似无害的推送,引发了雪崩。
这种事儿干技术的谁没碰上过?保障性技术,说白了,就是防止这种半夜鸡叫的玩意儿。可别以为它只是一堆工具和流程,它更像是一种肌肉记忆,一种深入骨髓的设计哲学。
这几年,行业里动不动就提“高可用”“弹性架构”,但真出了事,该挂还是挂。保障性技术不是拿来吹的,是拿来用的。你得把它揉进每一次代码提交、每一次架构评审、每一次上线变更里。你猜怎么着?很多公司,连最基本的单元化都还没搞明白,就急着上微服务,结果故障域越拆越大……
保障性技术不是“修补匠”
很多人以为,保障性技术就是出了事儿再打补丁,加个监控,做个备份。大错特错。它是一种主动防御,从架构设计之初就考虑:如果这笔交易失败,能不能优雅降级?如果这个机房地震了,用户会不会感知?这些问题,不是事后一句“我们下次注意”就能糊弄过去的。
这几年,混沌工程异军突起。简单讲,就是主动在生产环境搞破坏,故意注入故障,看系统能不能扛住。Netflix的Chaos Monkey是祖师爷,但现在国内大厂也都玩得挺溜。比如阿里,每年双十一前的全链路压测和故障演练,简直像一场军事演习。你想想,主动把子弹射向自己,然后看盔甲够不够硬——这种思路,挺反直觉,但真管用。
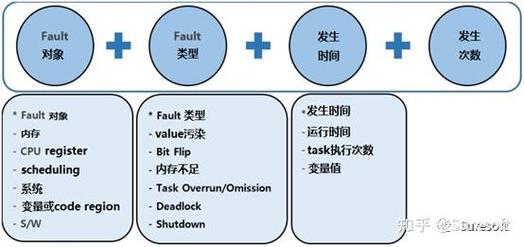 混沌工程实验注入故障示意图
可别以为上线个猴子就万事大吉。混沌实验最难的不是技术,是文化。你突然把生产搞挂,业务方能把你撕了。所以,得从最小范围开始,一点点建立信心。我就见过一个团队,偷偷摸摸做实验,结果真弄出一个隐藏很深的死锁bug,老板从此大力支持,你说逗不逗?
从SRE到“向左移”,究竟在移什么?
SRE(站点可靠性工程)这几年很火,火到我都有点审美疲劳。但不得不承认,它把运维的活儿变得更工程化了。Google那套SLO/SLI/SLA的指标体系,让可靠性可量化,不再是一笔糊涂账。不过话说回来,很多团队引入SRE,最后搞成了换了个名字的运维,根本没触达核心。
真正让我眼前一亮的是“安全左移”和“质量左移”。过去我们总把测试、安全审查放在流程后面,现在呢?代码还没写,需求评审阶段就要讨论:这个功能如果被恶意利用怎么办?这个接口如果瞬间涌入10万QPS,会不会拖垮数据库?左移,移的不是工具,是意识。这玩意儿,才是保障性技术的精髓。
等等,你是不是觉得这有点理想主义?确实。实际落地时,业务压力一来,老板喊一声“先上线再说”,所有的保障流程都成了摆设。所以,保障性技术最大的敌人不是技术本身,而是急功近利的心态。你说对吧?
云原生时代,保障性技术的新瓶旧酒
现在都在讲云原生,Kubernetes、Service Mesh、Serverless……听着高大上,但底层的兜底逻辑一点儿没变。容灾、降级、限流、熔断,这些老生常谈的手段,在微服务架构下反而更复杂了。一个服务挂了,可能通过连锁反应搞瘫半个系统。于是,Service Mesh出现了,把熔断、重试、负载均衡这些事下沉到Sidecar,让业务代码更干净。可是,Sidecar本身会不会成为瓶颈?唉,永远有填不完的坑。
前阵子,某视频网站因为CDN故障,直接上了热搜。你猜怎么着?事后发现,故障的原因不是没做容灾,而是容灾切换的脚本有个bug,没切过去。这就像一个灭火器,关键时刻喷不出干粉,你说气不气人?保障性技术必须常态化演练,不然就是纸上谈兵。我见过最牛的公司,每周都会随机抽一个服务,直接关掉,然后看整个团队的响应速度。这比任何PPT汇报都实在。
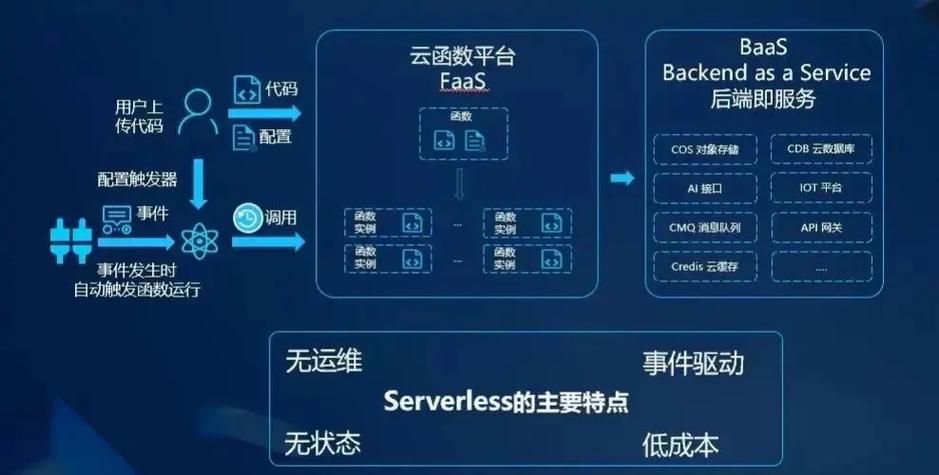 云原生服务网格熔断机制示意图
说到演练,很多人觉得就是走个过场,写个报告。拜托,你那不叫演练,叫演戏。真正的演练,要敢动真格,要在非预期的时间突然发起,然后记录真实的修复时长。这样暴露出来的问题,才是金矿。比如,你发现监控报警延迟了五分钟,或者某个负责人压根联系不上——这些细节,平时根本不会注意。
保障性技术的未来:AI能救场吗?
最近AI Ops概念挺热,用机器学习预测故障,自动修复。梦想很美好:系统自己感知流量洪峰,提前扩容;半夜宕机,AI自动定位根因并执行预案。可现实骨感得很。我试过几个开源的AI Ops工具,误报率高得离谱,一会儿告警风暴,一会儿又漏报。最后还得靠老司机人肉看盘。不过,这并不代表AI没用。在异常检测、根因分析上,结合知识图谱和日志挖掘,确实能辅助快速定位。只是,它还不能替代人类工程师对复杂业务的理解。
说到底,保障性技术是人和工具的结合。技术再花哨,没有人去持续维护、演练、复盘,都是花架子。我特别反感那些吹得天花乱坠的方案,一套一套的,落地就变形。还不如踏踏实实把监控数据理清楚,把变更流程规范好。变更,永远是故障的第一来源。管住变更,就管住了一半的风险。这事说着简单,做起来需要铁腕手段。比如,规定周二周四才能上线,晚上十点后禁止操作——这些死板的规定,往往比啥智能工具都管用。
写在最后?不,这只是开始
 写在最后?不,这只是开始
我不喜欢总结,因为技术永远在演进。保障性技术,说到底是“居安思危”四个字。在你最得意的系统上,总有一次故障等着你。我们能做的,就是不断假设失败,验证假设,循环往复。这个过程,有点枯燥,有点苦逼,但这也是工程师的乐趣所在——在混沌中建立秩序,在崩溃边缘保持优雅。
所以,别再问为什么凌晨三点要起来处理告警了。因为选择了这条路,就得扛起这份责任。谁让我们是搞技术的呢?