技术复盘方法:别再让同样的bug毁掉你的周末
那天,服务器又挂了。凌晨两点,我正梦见自己在海滩度假,突然被电话炸醒。线上订单量暴跌,技术群已经炸锅。我睡眼惺忪地打开电脑,看着监控曲线像自由落体一样,心里那个火的啊——这场景怎么就这么熟悉呢?两个月前,不也是因为一条慢查询搞瘫了数据库吗?说实话,该做的复盘我们都做了,文档写得漂漂亮亮,还开了总结会,领导都点头了。可为什么问题还是反复出现?那一刻我意识到,我们的“复盘”,根本就是假的。
 服务故障时间线重建示意图
有一次,我们一个推荐算法服务突然返回空列表,影响了好几千用户。第一反应是模型挂了?但检查模型服务状态正常。顺着时间线查,发现是上游的数据清洗任务延迟,导致特征缺失,模型就只能给个默认空结果。可为什么数据清洗会延迟?再往下挖,发现是当天凌晨一个批处理脚本因为有人改了表结构而失败。再问,改表结构是为了一个临时的运营活动,没通知数据组。你看,从算法效果差一路挖到沟通流程漏洞,整整挖了四层。如果只停在第一层,下次照样出问题。很多技术人太容易满足于表面的技术原因,而不去碰组织那根神经。不过话说回来,挖太深容易得罪人,这就要看你有没有那个胆了。
 把复盘变成肌肉记忆
复盘完了,写了满满当当的改进措施,然后呢?靠大家自觉执行?别做梦了。人都是健忘的,尤其在一个迭代飞快的团队里,下个Sprint一来,谁还记得上个月的惨痛教训。所以必须把措施固化到流程或者工具里,让系统替你记着。
我见过最有效的一招,是把复盘出来的检查项直接塞进上线checklist。当初我们因为配置文件少了一个逗号,整个服务起不来,复盘后我们强制要求所有配置文件必须通过一个简单的语法校验脚本才能合并代码。那个脚本花了十分钟写,后来至少挡住了五次类似问题。这才叫真正的靠谱。另外,一些关键的监控阈值,也是从血泪里提炼的。比如某次缓存穿透差点打挂DB,后来我们不仅加了布隆过滤器,还设了一个P99延迟超过200ms就自动降级的策略。这些数字不是拍脑子想的,是上一次故障里实际测试出来的。
还有一种方式,我强烈推荐,就是定期的灾难演练。不是走形式那种。我们团队每个季度会随机挑一个过去发生过的故障场景,在生产环境的镜像里重放,看看大家响应速度怎么样,改进措施有没有真正落实。第一次搞的时候手忙脚乱,才发现当初以为万无一失的预案,有一步手册里少写了个命令,导致自动切换脚本运行失败。当场惊出一身冷汗——幸亏是演练,不是真事故。很多人觉得演练成本高,可比起线上故障的损失,这点成本算什么?对吧。
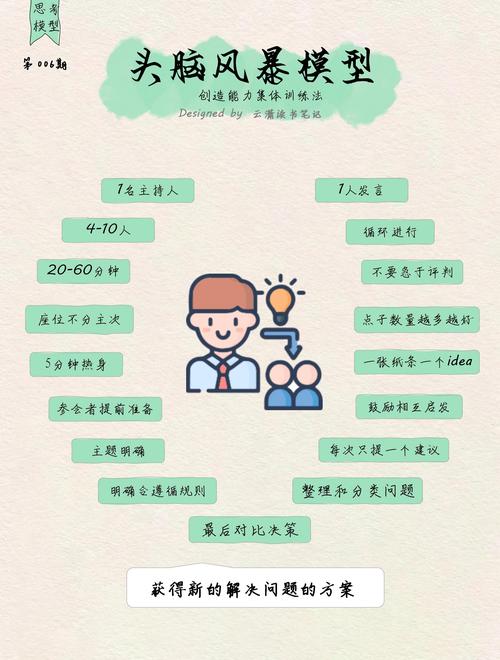 跨团队技术复盘会议头脑风暴
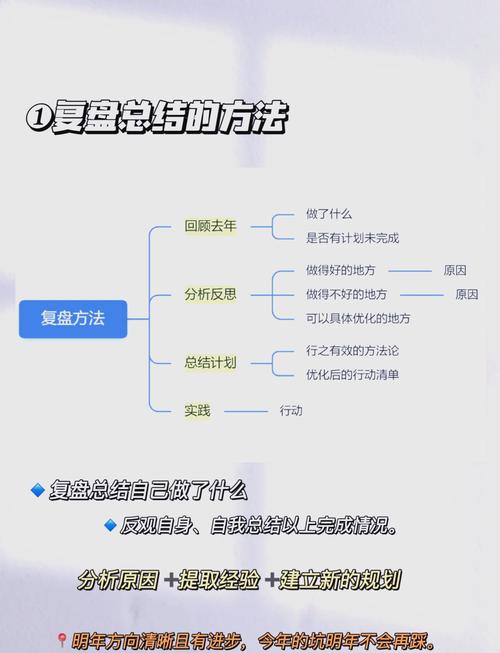 复盘最大的坑:以为改了就不会再犯
最后泼盆冷水,再好的复盘也防不住所有问题。系统在演进,业务在变化,人的疏忽永远存在。复盘真正的价值,是提升整个团队对故障的认知水平,让我们下次遇到类似苗头时,能早嗅到异味。就像老司机,开多了各种路况,对危险有预感。技术复盘同样如此。
我坚持写了五年复盘笔记,从最初记流水账,到现在结构化地记录故障现象、根因链、改进及验证结果。偶尔翻翻,还能笑出声:当年那个因为多线程竞争导致的数据错乱,今天看来简直低级得可笑。但正是这些可笑的东西,堆出了现在的编码直觉。所以别怕复盘麻烦,也别追求一劳永逸。哪怕每次只进步一点点,只要还在复盘中诚实面对自己,团队就在变强。
说实话,下次凌晨被叫起来,我希望是因为好消息,而不是同一个老问题又来敲门。共勉。
复盘不是写作文,是挖坟
很多团队把复盘搞成了形式主义。出问题后,拉个文档,按模板填:问题描述、原因分析、改进措施。然后归档,再也没人看。拜托,这种流水账能有什么用?我见过最夸张的一次,复盘文档里写“原因:网络抖动”,改进措施是“加强监控”。然后呢?下次换个服务继续抖动。这根本不是复盘,是敷衍。 真正的复盘,得像考古一样去深挖根因。你还得有点破案的劲头。我习惯把故障时间线一丝不挂地拉出来——几点几分哪个服务先报错,多少秒后关联服务开始超时,用户侧的表现是什么。这过程特别考验人的耐心,有时候盯着日志看了两小时,就为了确认一个时间戳。但只有这样,才能还原出事故的全貌。说实话,没有时间线的复盘都是耍流氓。这里有个技巧,我一般会画个图,把事件按秒排列,连带上当时的系统指标,一眼就能看出故障传导路径。强烈建议你也试试。服务故障时间线重建示意图
有一次,我们一个推荐算法服务突然返回空列表,影响了好几千用户。第一反应是模型挂了?但检查模型服务状态正常。顺着时间线查,发现是上游的数据清洗任务延迟,导致特征缺失,模型就只能给个默认空结果。可为什么数据清洗会延迟?再往下挖,发现是当天凌晨一个批处理脚本因为有人改了表结构而失败。再问,改表结构是为了一个临时的运营活动,没通知数据组。你看,从算法效果差一路挖到沟通流程漏洞,整整挖了四层。如果只停在第一层,下次照样出问题。很多技术人太容易满足于表面的技术原因,而不去碰组织那根神经。不过话说回来,挖太深容易得罪人,这就要看你有没有那个胆了。
把复盘变成肌肉记忆
把复盘变成肌肉记忆
复盘完了,写了满满当当的改进措施,然后呢?靠大家自觉执行?别做梦了。人都是健忘的,尤其在一个迭代飞快的团队里,下个Sprint一来,谁还记得上个月的惨痛教训。所以必须把措施固化到流程或者工具里,让系统替你记着。
我见过最有效的一招,是把复盘出来的检查项直接塞进上线checklist。当初我们因为配置文件少了一个逗号,整个服务起不来,复盘后我们强制要求所有配置文件必须通过一个简单的语法校验脚本才能合并代码。那个脚本花了十分钟写,后来至少挡住了五次类似问题。这才叫真正的靠谱。另外,一些关键的监控阈值,也是从血泪里提炼的。比如某次缓存穿透差点打挂DB,后来我们不仅加了布隆过滤器,还设了一个P99延迟超过200ms就自动降级的策略。这些数字不是拍脑子想的,是上一次故障里实际测试出来的。
还有一种方式,我强烈推荐,就是定期的灾难演练。不是走形式那种。我们团队每个季度会随机挑一个过去发生过的故障场景,在生产环境的镜像里重放,看看大家响应速度怎么样,改进措施有没有真正落实。第一次搞的时候手忙脚乱,才发现当初以为万无一失的预案,有一步手册里少写了个命令,导致自动切换脚本运行失败。当场惊出一身冷汗——幸亏是演练,不是真事故。很多人觉得演练成本高,可比起线上故障的损失,这点成本算什么?对吧。
别一个人复盘,拉上冤种伙伴
搞技术的容易闷头自己反思,写个小结就完事。但我发现,团队跨角色的复盘,价值往往大得多。为什么?因为表面上是技术问题,根子可能在产品、运营甚至商务那。有一次API接口响应特别慢,复盘时拉上了后端、客户端和产品。后端说客户端请求参数不合理,客户端说后端没给文档,产品说自己也不知道这个接口被用来干什么了,是运营直接找的开发。最后发现是运营为了一次活动,临时搞了个批量查询,每次调1000条数据,还没走缓存。如果不把这些人拉到一起,后端可能默默优化了查询,下次运营换个花样,照样拖垮另一个接口。 这种跨部门复盘,火候很重要。不能变成批斗会。我通常会让每个人先花五分钟写下自己观察到的事实,而不是看法。比如“我发现日志里错误码500增多了”而不是“后端代码又出bug了”。这就避免了一上来就情绪对立。然后一起拼凑时间线,往往这时候会发现很多盲区——原来你以为别人应该知道的事,别人压根不知道。有一次,运维同学说“我重启服务器怎么没通知你们”,开发一脸懵“我们没收到任何通知啊”,结果是监控系统的告警静默期设置失误。这种沟通断点,不复盘根本暴露不出来。跨团队技术复盘会议头脑风暴
复盘最大的坑:以为改了就不会再犯
复盘最大的坑:以为改了就不会再犯
最后泼盆冷水,再好的复盘也防不住所有问题。系统在演进,业务在变化,人的疏忽永远存在。复盘真正的价值,是提升整个团队对故障的认知水平,让我们下次遇到类似苗头时,能早嗅到异味。就像老司机,开多了各种路况,对危险有预感。技术复盘同样如此。
我坚持写了五年复盘笔记,从最初记流水账,到现在结构化地记录故障现象、根因链、改进及验证结果。偶尔翻翻,还能笑出声:当年那个因为多线程竞争导致的数据错乱,今天看来简直低级得可笑。但正是这些可笑的东西,堆出了现在的编码直觉。所以别怕复盘麻烦,也别追求一劳永逸。哪怕每次只进步一点点,只要还在复盘中诚实面对自己,团队就在变强。
说实话,下次凌晨被叫起来,我希望是因为好消息,而不是同一个老问题又来敲门。共勉。