容错计算技术:那些永不崩溃的系统,骨子里藏着什么秘密?
前几天我刷到一条新闻,欧洲某航空公司的系统崩了,几千人滞留机场。评论区骂声一片,但有个评论特有意思:“都2024年了,这破事就没法避免吗?” 说实话,在计算机的世界里,故障才是常态。你手里的手机、桌上的电脑,还有背后支撑一切的数据中心,每一秒都在和错误较劲。而让它们即便出错也能苟住不崩的技术,就叫容错计算技术。这个词听起来挺学术,其实道理特朴素——别老想着不出错,出了错能兜住,才是真本事。
容错不是不犯错,而是会“补救”
很多人以为搞计算机的人,追求的是100%不出错。天真了。物理世界就没有绝对靠谱的东西——电子乱跳、温度一高电路就飘、甚至宇宙射线都能把你内存里的0打成1。容错的意思很简单:你错你的,我照样跑。上世纪60年代,NASA为了登月,给航天电脑搞了一套叫三模冗余(TMR)的机制:三个一样的电路同时算,少数服从多数。就算一个抽风了,结果还是对的。这方法笨到令人发指,但管用。毕竟在太空,你总不能按Ctrl+Alt+Del对吧?
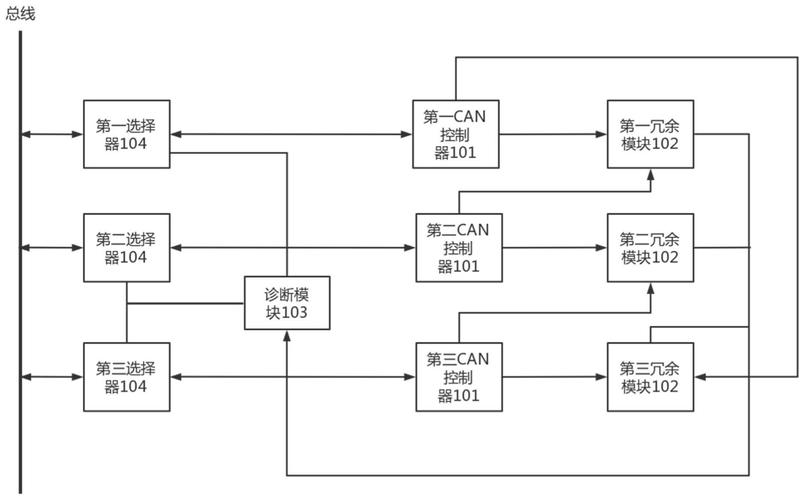 航天计算机三模冗余容错电路示意图
后来这个思路被搬进了各种地方。比如银行的服务器,不可能因为一个晶体管烧了就让你取不出钱。它们会搞热备份,一台机器宕了,另一台无缝接上,你甚至感觉不到停顿。但代价呢?烧钱。所以对普通人来说,容错往往是个“默不作声的高贵货”。
冗余这玩意儿,烧钱但管用
 冗余这玩意儿,烧钱但管用
你没听错,容错的第一大原则就是冗余。多存几份、多算几次,总能压住错误。现在你用的云服务,比如网盘里的照片,后台其实存了三份以上,分布在不同的机房。一个机房被挖机刨了,数据还在。这叫地理冗余。再比如服务器上标配的ECC内存,比普通内存每块多存几个校验位,能自动纠正单个比特翻转——就是那个被宇宙射线打翻的比特。家用电脑为啥不给用?厂家宁愿你蓝屏了重装系统,因为成本压在那儿。所以冗余设计说白了,是拿钱换可靠。
不过话说回来,现在芯片制程越来越小,3纳米、2纳米……听着挺牛,但缺陷率其实飙升了。晶体管太密,难免有个把次品。于是芯片设计里,容错成了必考题。比如AI芯片里面成百上千个计算单元,坏掉几个根本不影响最终识别结果,因为神经网络本身就有点“模糊计算”的味道。这种设计叫优雅降级——不是全崩了,只是稍微慢一点。
软件不死,全靠一手“假动作”
硬件容错烧钱,软件容错就鬼精多了。你一定遇到过:手机APP卡了,你切出去再回来,它又好了。这背后可能是进程突然崩溃,但又被系统悄悄拉起。像安卓或服务器上的检查点/重启技术,就是定期把运行状态存个档,一旦挂了,从上次存档继续,跟打游戏读盘一样。更绝的是Netflix,它们搞了个叫Chaos Monkey的工具,没事就在生产环境里随机杀服务器,逼着系统必须设计成容错的。这群工程师真是疯子——但效果奇好,现在亚马逊云宕机时,Netflix还能播,就靠这种“抗压测试”。
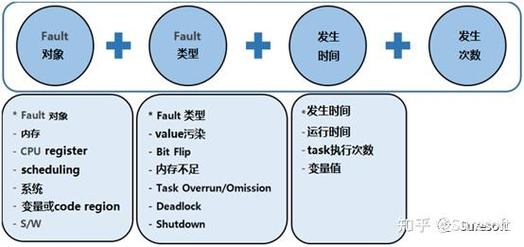 Netflix Chaos Monkey 随机故障注入测试环境示意图
还有一种特秀的招数叫断路器模式。当某个服务连续出问题,系统直接把它暂时断了,省得拖垮整个集群,就像你家电闸跳了保护整栋楼。现在微服务一拆一大把,这种隔离策略救了多少网站,数都数不清。
你的手机,已经是容错大师了
 你的手机,已经是容错大师了
说回你最熟的东西——手机。就你刷抖音那一下,数据包丢了好几个,手机自动请求重传,根本感觉不到。这背后是一套复杂的自动重传请求(ARQ)协议。还有你存的自拍,闪存芯片其实坏块一堆,主控芯片靠纠错码(ECC)和坏块管理,假装它们都不存在。甚至你的触摸屏,偶尔静电误触,算法也能滤掉。这些容错技术“偷偷”跑着,才让你觉得这玩意儿“从来不出错”。其实它已经错得千疮百孔了,只是没让你知道。
前阵子特斯拉召回那事儿还记得吗?自动驾驶的视情系统用了冗余设计,摄像头、毫米波雷达、超声波全堆上,一个失灵另一个顶上。虽然争议大,但思路没错——在安全攸关的系统里,容错是保命的东西。再往大了说,现在搞数字孪生、工业物联网,一套系统要扛几十年,中间硬件换代、软件升级,没有容错机制,早崩成豆腐渣了。
所以啊,下次你发现电脑没崩、网约车没乱派单、银行转账没丢——别觉得理所当然。背后是无数工程师在跟物理定律死磕,跟概率赌命。容错计算技术,说到底就是人类对抗不确定性的一点小聪明。而这小聪明,已经撑起了整个数字世界。