类脑芯片研发,我们离真正的硅基大脑还有多远?
上周在旧金山的一个闭门会上,看到英特尔Loihi 2的实测功耗数据——那边桌上就摆着一碟冷掉的薯条,大家完全顾不上吃。说实话,这玩意儿真的让我头皮发麻。14纳米工艺,单芯片就塞进了100万个神经元,功耗?微瓦级别。微瓦!
当时旁边有个做边缘计算的哥们儿,直接飙了句脏话,然后开始疯狂拍照。他那台无人机,目前用的还是传统GPU做避障,飞20分钟就得下来换电池。如果能把这东西换上……你想想。
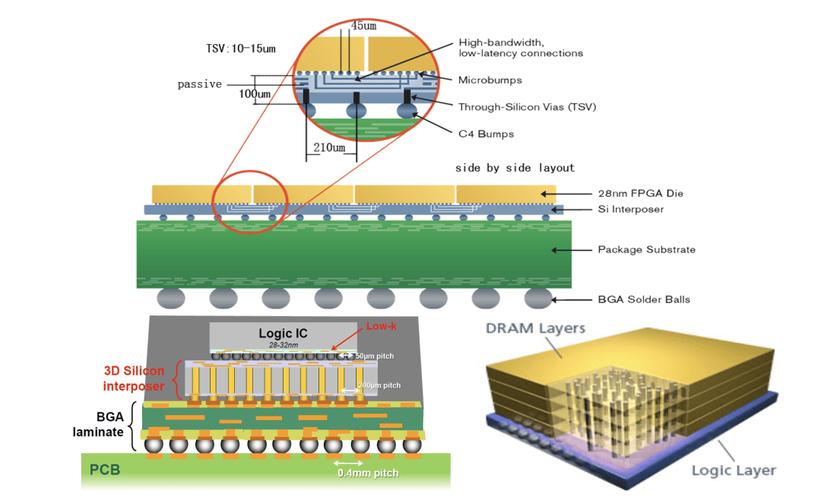 英特尔Loihi 2芯片显微结构图
不过,类脑芯片这词儿,这几年被炒得有点滥。好像贴上个“仿生”标签就能融资。我翻过国内一些初创的BP,架构图花里胡哨,仔细一看核心IP全是买的Synopsys的成熟库,也就改了个脉冲神经网络时序而已。这算什么类脑?
脉冲和时钟,根本不是一回事
传统芯片是时钟驱动的,像阅兵方阵,所有人都听一个哨子。而类脑芯片——至少真正做脉冲神经网络(SNN)的——那完全是另一套逻辑。事件驱动,稀疏计算。神经元不活跃就歇着,一旦有脉冲过来,才猛然触发。这就好比,你没必要一直盯着水壶等它烧开,听到鸣笛再起身就行。巨大能耗就这么省下来的。
但这里有个天大的坑:SNN的训练算法至今没有收敛得很优雅。反向传播在脉冲这种离散信号上不管用,你得用替代梯度,或者搞STDP(脉冲时间依赖可塑性)这种本地学习规则。STDP吧,好听叫“生物可解释性”,难听点就是——太糙了。我们实验室试过用STDP做cifar-10分类,拼了老命也就刚过80%。那边一个精简CNN轻松干到95%。老板直接说,这课题先放放。
存算一体?先把热散出去再说
还有个大家都爱说的概念,存算一体。把计算和存储做在同一个器件上,消除冯·诺依曼瓶颈。听起来美极了,对吧?
实际呢?我前东家做过一款基于ReRAM的存算一体demo芯片。跑矩阵乘法确实快,能效比高得离谱。但你知道它满负载运行时,片上的热点温差有多大吗?实测超过30摄氏度。某个交叉阵列的角落直接飙到接近90度,而几毫米外的地方才50多度。这种温度梯度,带来的噪声和寿命衰减,简直噩梦。信号本来就在模拟域做运算,一点点热噪声就能让精度崩掉。
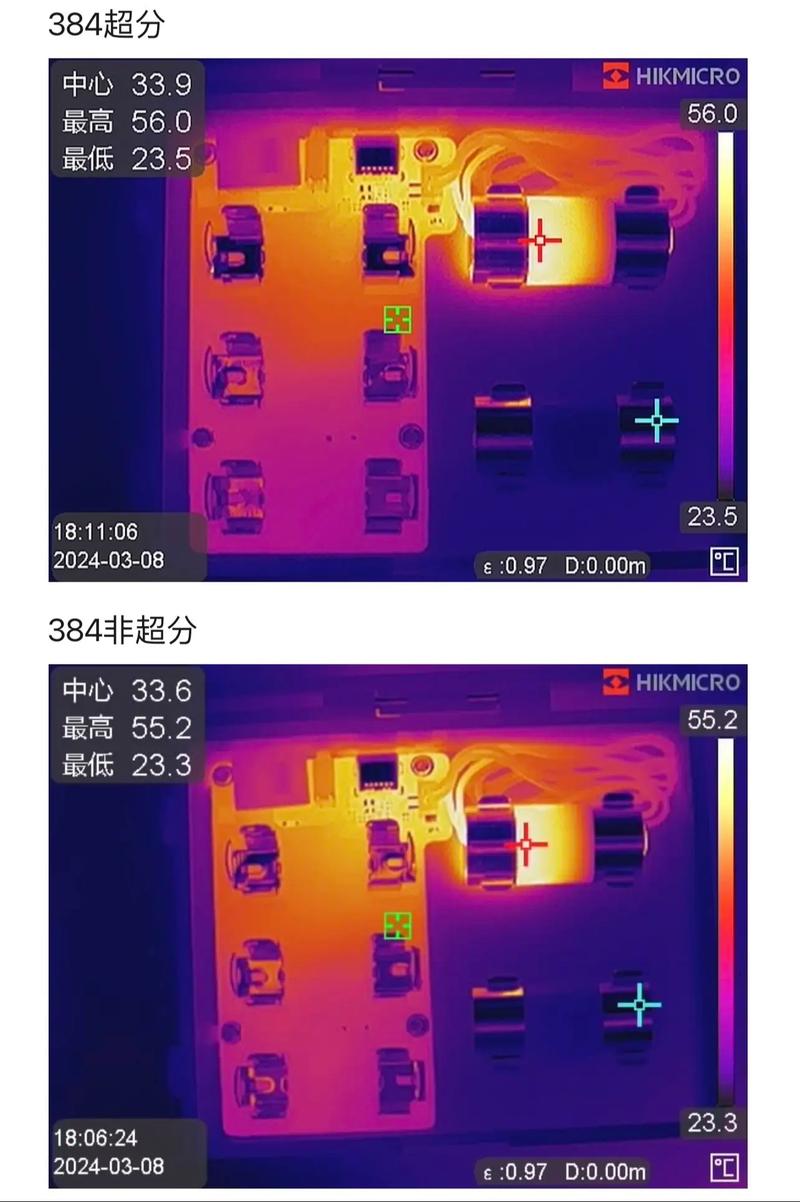 类脑芯片热力图分布热像仪拍摄
所以现在很多团队在搞数模混合,关键路径用数字电路保证鲁棒性,边缘部分用模拟去降功耗。比如中科院计算所那篇JSSC,他们那个多核架构就很取巧——每个SNN核自带一个小型ADC,把模拟电流转成数字脉冲再传出去,避免长距离模拟信号衰减。这思路我挺佩服的,不一根筋,实用主义。
软件栈才是隐形的杀手
 软件栈才是隐形的杀手
硬件再牛,没个好用的软件栈也是白搭。我当初学Loihi的时候,用那个Nx SDK,文档写得……唉,可能只有写代码的人自己能看懂。你想搭一个简单的两层全连接SNN,还得手动配置分区、设置栅格层级、定义突触压缩比。这鬼台阶式学习曲线,直接把很多搞算法的博士劝退了。
直到去年Lava框架出来,情况才好转一些。但比起CUDA那种生态,还差得远。毕竟老黄花了十几年砸钱搞CUDA大学计划,学校里从大一就开始教。类脑芯片这边,连个统一的基准测试集都没有。这个月清华团队在《自然·计算科学》上发了个“脑启发的持续学习基准”,我看总算有人开始填坑了。不过也就刚起步。哦对,他们那个基准要求连续学习100个任务不遗忘,用的芯片是天机芯二代,片上网络是2D mesh,吞吐量比上一代翻了五倍……但论文里没怎么提功耗,我猜可能不太好看。
说到这里突然想起,上周五跟一个投资人聊天,他问:你觉得类脑芯片什么时候能大规模落地?我差点把咖啡喷出来。大规模?现在连小规模都磕磕绊绊。不过有一条路可能更快——传感器端智能处理。比如DVS(动态视觉传感器)直接接一片SNN芯片,做手势识别或者碰撞预测,不需要主处理器介入。这个场景对精度要求没那么苛刻,但对功耗和实时性近乎变态。苏黎世联邦理工他们就用这个方案做了个扑翼飞行器的避障,整机功耗才几百毫瓦,包括电机。这比搞通用人工智能靠谱多了。
当然,谁也不知道哪块云彩会下雨。十年前没人认为深度学习能井喷。也许类脑芯片就差那么一个突破性算法,或者一种新器件——比如现在大火的忆阻器集群,如果一致性控制得再好一点,或许真能搞出点大动静。不过,在那之前,这领域还是得靠一帮子不信邪的疯子撑着。毕竟,用硅基复制碳基的智慧,本身就是件挺悲壮又带点浪漫的事,不是吗?