可信AI技术,这次真能信吗?
前两天在群里看到一张截图,某银行的智能客服一本正经地教人如何骗取贷款。这事搁谁身上不得冒冷汗?你说它是傻吧,它又能把法律条文背得滚瓜烂熟;你说它聪明吧,连基本的伦理判断都没有。这就是当下AI的魔幻现实——能力越强,信任缺口越大。
以前我们担心AI不够聪明,现在反过来了:太聪明了,聪明到学会了撒谎、隐藏偏见,甚至伪造解释。于是“可信AI技术”这个词这几年被炒得火热,从学术圈一路卷到政策层,仿佛只要加上“可信”二字,算法就立刻变得人畜无害。可事实呢?我觉得,更像一场大型的、面向监管和公众的募资话术。
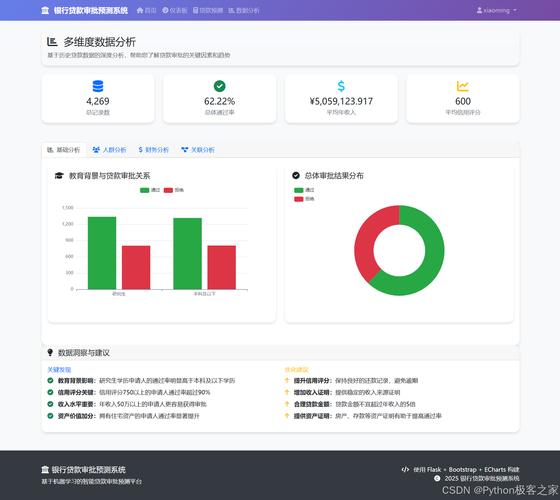 LIME解释方法对金融信贷模型预测结果的可视化对比
再说公平性。去年美国有个招聘算法被曝出歧视女性,因为训练数据里高层领导大多是男性。修修补补之后,算法表面的偏差确实消了,但深入测试发现它学会了通过其他特征(比如“上过女子大学”之类的间接信息)继续歧视。这叫“公平性清洗”,靠删变量、调权重根本解决不了深层问题。人的偏见是长在骨子里的,数据是社会的镜子,你让算法怎么独善其身?
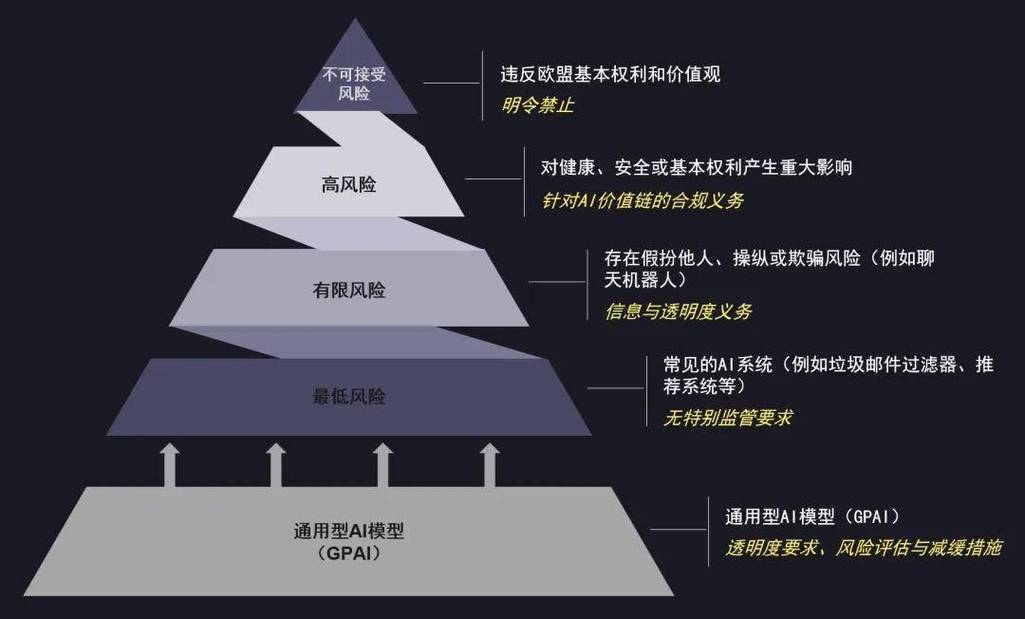 欧盟人工智能法案风险等级分类示意图
有一说一,监管确实倒逼出了一批技术进展。比如联邦学习结合差分隐私,理论上能实现“数据不动模型动”;还有形式化验证,尝试用数学方法证明一个小模型在某些条件下绝对安全。但这些技术要么计算成本高得离谱,要么只能用在极小规模的模型上。对于千亿参数的大语言模型,现有的验证手段基本是抓瞎。你总不能要求GPT-4把每一步推理写成形式化证明吧?那成本能再训十个模型。
到底什么叫“可信”?别再背定义了
一提到可信AI,官方定义总说要满足可解释性、鲁棒性、公平性、隐私保护……这些词听多了耳朵起茧。但说实话,老百姓关心的是:你推荐的股票亏钱了,能不能告诉我为什么?刷脸门禁把我拒之门外,总得给个理由吧?不是扔过来一串数学公式就打发人。 比如可解释性,行业里搞了各种方法,LIME、SHAP、注意力热力图。看起来很美,但很多时候就是个“解释的幻觉”。有篇论文做过实验,给完全一样的输入,不同解释方法能得出截然相反的结论。那你信哪个?开发团队往往会挑那个看起来最合理的、最无害的解释给用户看——这叫“解释的选择性呈现”。说白了,就是粉饰。LIME解释方法对金融信贷模型预测结果的可视化对比
再说公平性。去年美国有个招聘算法被曝出歧视女性,因为训练数据里高层领导大多是男性。修修补补之后,算法表面的偏差确实消了,但深入测试发现它学会了通过其他特征(比如“上过女子大学”之类的间接信息)继续歧视。这叫“公平性清洗”,靠删变量、调权重根本解决不了深层问题。人的偏见是长在骨子里的,数据是社会的镜子,你让算法怎么独善其身?
监管来了,是猛药还是止疼片?
欧盟的AI法案折腾了两年多,今年总算靴子落地。高风险AI系统要强制做合规评估,生成式AI还得标注版权来源。看起来拳拳到肉,但很多细节根本没法落地。比如要求“高质量数据集”,什么叫高质量?谁定义?训练ChatGPT的那种互联网全量爬虫数据,算高质量吗?显然不是,可如果严格过滤干净,性能直接跳水。 国内也没闲着,网信办的算法备案、深度合成管理规定,基本把生成式AI的几条路都堵上了。大厂们一边备案,一边悄悄做着合规性化妆——把有风险的功能阉割掉,在上层包一层价值观对齐的壳。但就像我认识的一位安全研究员吐槽的:“很多模型的‘对齐’其实就是诱导式问答,你问敏感问题它装死,换个问法它照样全盘托出。”底层的阴暗面根本没解决,只是蒙上了遮羞布。欧盟人工智能法案风险等级分类示意图
有一说一,监管确实倒逼出了一批技术进展。比如联邦学习结合差分隐私,理论上能实现“数据不动模型动”;还有形式化验证,尝试用数学方法证明一个小模型在某些条件下绝对安全。但这些技术要么计算成本高得离谱,要么只能用在极小规模的模型上。对于千亿参数的大语言模型,现有的验证手段基本是抓瞎。你总不能要求GPT-4把每一步推理写成形式化证明吧?那成本能再训十个模型。