推荐系统技术的爱恨情仇:一个老码农的碎碎念
我被协同过滤坑的那几年
刚入行的时候,觉得CF这玩意儿真神奇。你买了尿布,它推你啤酒。——这事儿传烂了。但实际呢?稀疏矩阵能让你怀疑人生。冷启动?呸,新用户一来,系统就瞎了。我还记得那天凌晨三点,盯着那个0.03的AUC值,想砸电脑。
后来试了矩阵分解,SVD跑起来……慢得像老牛拉车。不过一旦收敛,效果拔群。用户向量和物品向量,在隐空间里凑得越近,推荐就越靠谱。但调参?哎,学习率稍微高点,loss就爆炸给你看。有一次我脑抽,设了个0.01,整个模型在训练集上直接过拟合成白痴。同事说,你这推荐的不如随机。
后来学乖了,ALS交替最小二乘,分布式跑起来快些,但那个正则化系数,调得我脱发。真的,地上掉的头发比代码行数还多。
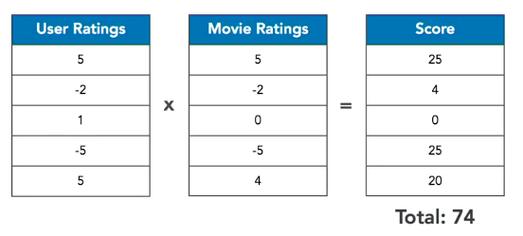 电影推荐系统协同过滤矩阵分解对比
深度学习的糖衣炮弹
紧接着,DNN来了。YouTube那篇论文,Deep Neural Networks for YouTube Recommendations,当时读得我热血沸腾。两层网络,一个做召回,一个做排序。特征工程都省了大半。但我们小厂哪有那么多数据?百万级用户量,喂不饱深网络啊。硬上,结果就是——过拟合得亲妈都不认识。验证集上AUC虚高,上线后CTR跌成狗。
不过说实话,wide & deep 确实好用。记忆能力和泛化能力结合,就是得防着特征穿越。有一次线上事故,我们把未来的曝光当特征用了,CTR虚高得离谱,老板差点把我开了。那叫一个刺激。后来加了个时间戳校验,才保住饭碗。
现在模型都开始比谁大了。前阵子试了一个双塔模型,用户塔和物品塔,分别输出向量,然后点积算相似度。上线那晚,服务器风扇狂转,延时从50ms飙到200ms,用户投诉电话打爆客服。连夜切回老模型,真TM狼狈。但效果确实好,离线AUC涨了5个点,不用又不甘心。
 YouTube推荐系统wide and deep模型架构图
实时性与大模型的迷思
 实时性与大模型的迷思
现在都吹实时推荐,Flink搞起来,用户点一下,下一刻推荐就变。但链路过长,延迟一高,用户早跑了。我们想了个馊主意,把离线模型和在线规则混着用。勉强能打。比如,离线算出候选池,在线根据最近三分钟行为,用ES做轻量级排序。丑是丑了点,但实用。
大模型火成这样,推荐系统能不被卷?用BERT做序列推荐,拿用户行为序列当句子。效果是上去了,成本也上去了。推理一次好几毛钱,用户多了,服务器都烧穿。我们只好搞蒸馏,把大模型的知识挤到小模型里。挤出来一股馊味——效果打折。但能咋办?穷啊。后来试了LLM for 特征增强,用GPT生成物品种类描述,塞进传统模型。嘿,还真有用,CTR涨了2%,而且不增加线上负载。这可能是条歪路,但架不住它省钱。
移动端推荐更是一言难尽。屏幕小,用户耐心差,推荐位就那么几个。我们搞了个端侧轻量级重排,用NCNN部署模型,实时重排。结果模型权重一更新,APP包体积大了5M,用户卸载率当场飙升。真是按下葫芦浮起瓢。但你又不能不做,因为场景化推荐确实有效,比如用户在厨房,推菜谱,在卧室,推助眠音乐。多模态特征一加,视频和图片的推荐准头明显高了。只是数据处理链路脏得一批,标注好的图像标签,一半是错的。我亲自洗了三天数据,感觉眼神都不好了。
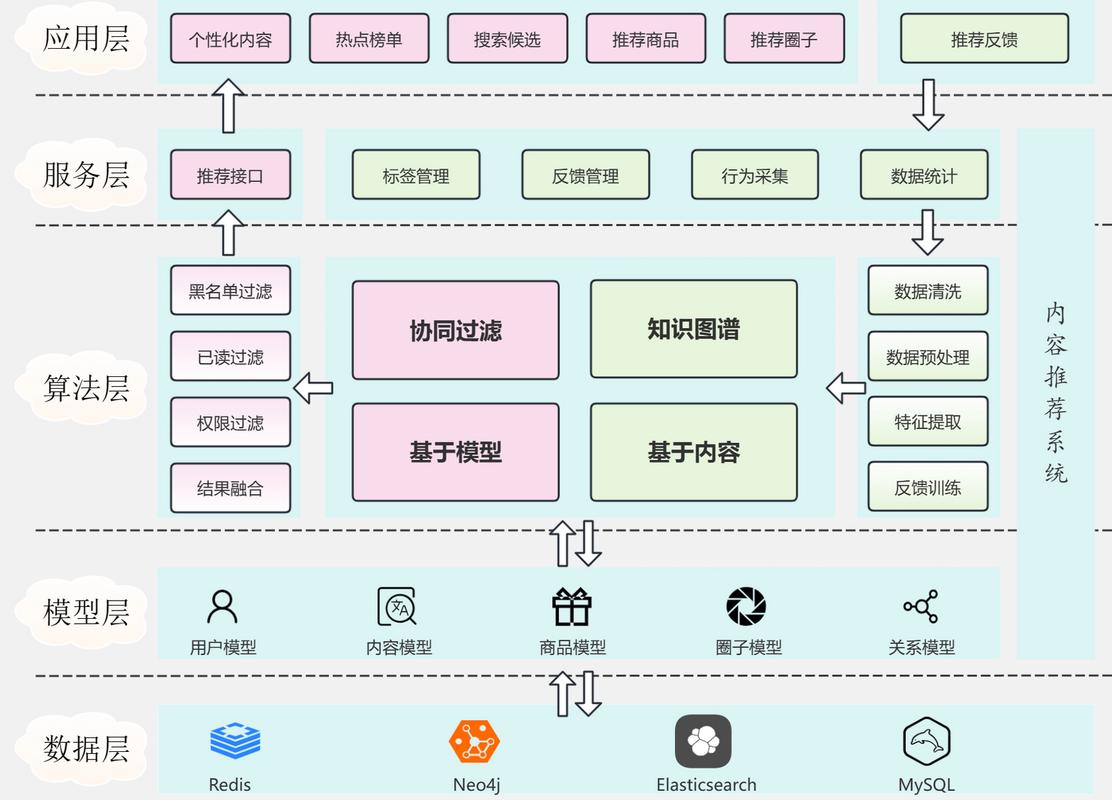 移动端实时推荐系统架构图
行了,扯了这么多,该去搬砖了。推荐系统这坑,且填且珍惜。回头看看,搞了这么多年,最大的体会就是:模型越复杂,出问题越难查;业务理解比算法重要一万倍。那个,你觉得呢?