搞自然语言处理的人,到底在纠结什么?
去年冬天,一位做语言学朋友突然问我:『你们搞自然语言处理的,是不是快失业了?现在ChatGPT什么都能写,还翻译得比人好。』我愣了几秒——说实话,那一瞬间我真不知道怎么回。因为他说得…不全错,但就是哪里不对。那种感觉,就好像有人跟你说『既然有了微波炉,厨师这个职业就该消失了吧』。拜托,人类吃饭这件事,哪里只是加热那么简单。
对,自然语言处理(NLP)这领域,现在热得发烫,也乱得离谱。外行看热闹,内行看门道,但门道里面还有一层又一层的迷宫。我自己踩过无数坑,以至于每次看到媒体吹嘘『AI又通过图灵测试了』,我都想砸键盘。真的,别闹。
那些年,我们手写的规则
我读研的时候,导师扔给我一本《自然语言理解》,封面都泛黄了。里面讲的全是规则:句法分析树、依存关系、格语法……那时候做对话系统,你得一条条写 if-else。用户说『我要订机票』,你得先抓到动词『订』,再找宾语『机票』,如果用户说『帮我订一张去北京的机票』,哦,又多了目的地。问题来了——万一他说『我想去北京,你能不能帮我看看机票』呢?规则顿时就像筛子,到处都是漏洞。我当时写了三千多条规则,自认为覆盖了大多数情况,结果测试的时候,一个同事随口说『下周五有没有飞上海的不是红眼航班』,系统直接崩了。我真的,那天晚饭都没吃下去。
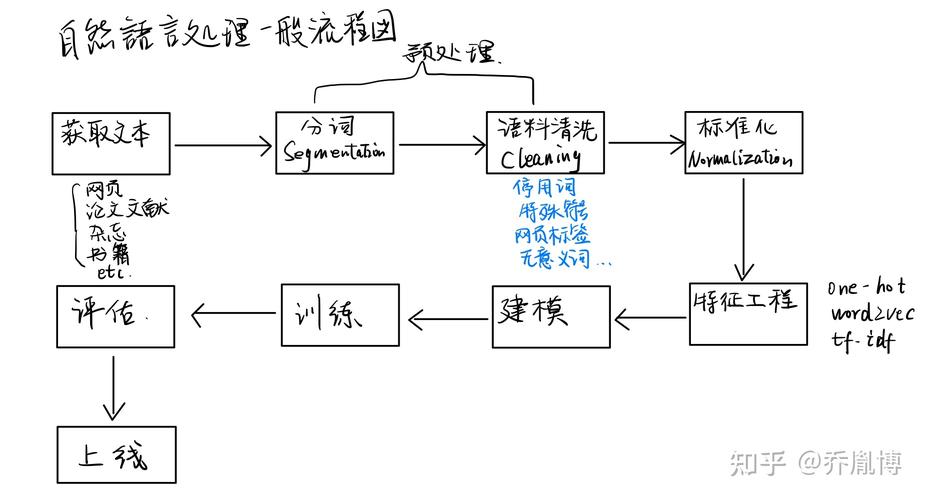 早期自然语言处理手写规则流程图
现在想想,那种方法就像是用竹篮打水。人类语言的多变性、模糊性、上下文依赖,根本不是几行规则能兜住的。一个『能』字,在『我能吃饭』和『你能去死吗』里完全两个意思。规则怎么穷举?写到死也写不完。更别提方言、俚语、反讽……我至今记得一个经典笑话:机器翻译把『The spirit is willing but the flesh is weak』(心有余而力不足)翻成『酒是好的但肉坏了』。这哪里是翻译,这是恐怖片。
概率来了,世界亮了又没完全亮
后来,统计方法杀进来了。说实话,我第一次用N-gram模型跑出一个语言模型,看到困惑度下降,那种惊喜感——就像在黑暗隧道里走了三年,突然看见萤火虫。原来语言可以这么玩儿:不用写规则,让数据说话。我们收集大量语料,训练模型去猜下一个词。『今天天气真___』,模型在大量文本里见过很多次『好』『差』『热』,它就能给出概率分布。这种思路直接催生了机器翻译、语音识别、输入法联想……哇,当时觉得世界要变了。
但它又笨得可以。N-gram只能看前面两三个词,长距离依赖完全抓瞎。『我那个朋友,就是昨天在咖啡馆遇到的,后来听说去了美国的那个人,他___』——填什么?N-gram大概率会输出『说』或者『是』,因为它只知道最近几个词是『那个人,他』。至于前面那一大串修饰,它根本记不住。这导致很多应用卡在准确度上不去,尤其对话系统,聊着聊着就变智障。
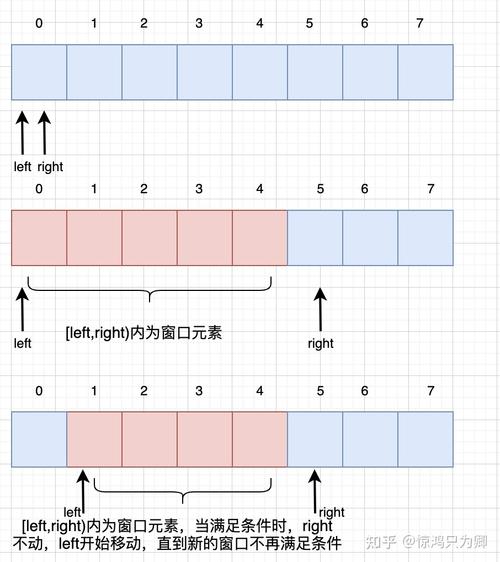 统计N-gram模型滑动窗口示意图
再往后,神经网络词向量出现了,Word2Vec,GloVe……哎哟,那阵子paper井喷。我们突然能把词语映射到高维空间,语义相近的词距离就近。『国王 - 男人 + 女人 = 女王』,这种向量运算简直像魔术。我开始疯狂做实验,发现很多有趣现象:词向量里居然有偏见,『医生』靠近『男人』,『护士』靠近『女人』;『程序员』附近全是雄性代词。这给后来的AI伦理埋下了雷。好玩吧?技术越精妙,它越像一面镜子,照出人类自己的毛病。
Transformer时代:大力出奇迹,但奇迹有代价
2017年,一篇叫《Attention Is All You Need》的论文横空出世。当时我正被RNN的梯度消失折磨得掉头发,读完这篇,凌晨三点在实验室来回踱步——这帮人直接抛弃了循环结构,全靠注意力机制!简单说,模型可以同时关注输入序列里所有位置,动辄几百层的计算,把上下文的关联权重算得明明白白。后来的BERT、GPT系列,全在这基础上堆数据、堆算力。GPT-3出来的时候,我拿它写诗、写代码、写情书,好家伙,有些句子比人写的还动人。那一刻我是真的又兴奋又焦虑。兴奋的是技术进步,焦虑的是——这玩意儿到底懂不懂它写的东西?
后来大家发现了,它不懂。它只是一个超大规模的条件概率模型,看到『天空是___』,就吐出『蓝色的』,因为训练语料里这么搭配最多。但凡你问点需要推理的:『如果我把一杯水倒进冰箱,它会变成什么?』它说『冰块』,但问『为什么冰块会浮在水面上?』它可能就开始胡说。因为它没有物理世界的经验,它只是个文字接龙大师。更可怕的是幻觉——模型会一本正经地编造事实,比如告诉你『爱因斯坦发明了电话』,语气坚定得让你怀疑自己学的历史。这在医疗、法律场景里简直是灾难。
 Transformer多头注意力机制可视化热力图
然后呢,就是现在——大模型军备竞赛,参数从千亿到万亿,能耗巨大,烧钱如纸。小公司根本玩不起,学术界也快跟不上,因为没资源做大规模实验。我们开始反思:这条路是不是走得有点偏?人类学会语言,只需要几千万词的输入,就能掌握复杂的语法和概念组合,而模型要吞掉整个互联网的文本,还动不动胡说八道。这里头一定缺了点东西,可能是符号推理,可能是具身认知,可能是因果推断——反正光靠『预测下一个token』永远到不了真正的理解。
所以,回到那个问题:我们失业了吗?
没呢。但工作内容彻底变了。现在我们更多在做约束、评估、对齐,确保模型别太放飞自我。你看到的ChatGPT,背后有大量的人工标注、强化学习反馈、安全过滤。做NLP的人,从『造轮子』变成了『驯兽师』——你得摸清模型的脾气,知道什么提示能引出好结果,什么情况它会犯浑。而且,现实中绝大多数场景不是聊天,而是抽取、分类、检索、情感分析,这些都需要精细的领域适配。你以为银行客服能用通用大模型吗?数据隐私、术语准确性、合规性……一上就死。
还有多语言,别看英文任务刷榜刷得飞起,换到小语种,方言,还是渣。我最近在做一个少数民族语言的词性标注,语料少得可怜,预训练模型根本不顶用,还得用回传统的特征工程加少量标注。你看,技术不是一把万能钥匙。
至于未来,我倒觉得,自然语言处理可能会分化成两条路:一条继续追求大而全的通用智能,一条深耕行业,做小而美的专家模型。或者,有天才跳出来发明一种全新的架构,比Transformer更高效,更接近人脑。谁知道呢?这行当最刺激的就是——你永远猜不到下一个突破会从哪冒出来。就像当年我在实验室熬夜写规则时,怎么也想不到,几年后我会对着一个黑盒子说:『帮我写一个悲伤的关于下雨的俳句』,然后它真就写出来了,还让我鼻子一酸。
行了,不扯了。我得去调参了,模型又把『天冷多穿点』翻译成『Sky cold wear more point』,够我忙一下午的。自然语言处理,痛并快乐着。