云计算平台构建:从踩坑到曙光,我的几点真话
那天半夜两点,服务器又挂了。我看着监控屏幕,血压上来了——这已经是本月第三次了,就因为一个没考虑到的资源争抢。搞云计算平台的,谁还没点血泪史?说实话,我有时候觉得我们这群人就是高级水管工,只不过修的是看不见的管子。不过话说回来,这几年在实验室里鼓捣的东西,真搬到线上环境里,那惊悚程度堪比拆盲盒,对吧?
为啥总在半夜崩?——谈谈自动扩缩的坑
 为啥总在半夜崩?——谈谈自动扩缩的坑
你肯定遇到过:流量突然上来,扩容策略慢半拍,然后服务就挂了。经典的HPA(水平自动扩缩)基于CPU和内存,但现实世界的负载哪有那么简单?我有个朋友——对,就是那种‘我有一个朋友’——他们的系统有次因为数据库连接池打满,CPU根本没上去,可系统已经半死不活了。这类问题逼着我们往预测性弹性伸缩上钻。我们团队去年发了一篇顶会,核心就是把时间序列预测和强化学习塞进调度里,提前预判流量波峰。你猜怎么着?实验数据漂亮得不行,响应延迟降了40%。但一上线,完蛋,模型对冷启动时间预判太乐观了,实例刚起来,流量已经过去,白扩容了!后来我们加了预热缓冲池,把常用镜像缓存着,启动时间从分钟级压到秒级,这才真的顶用。
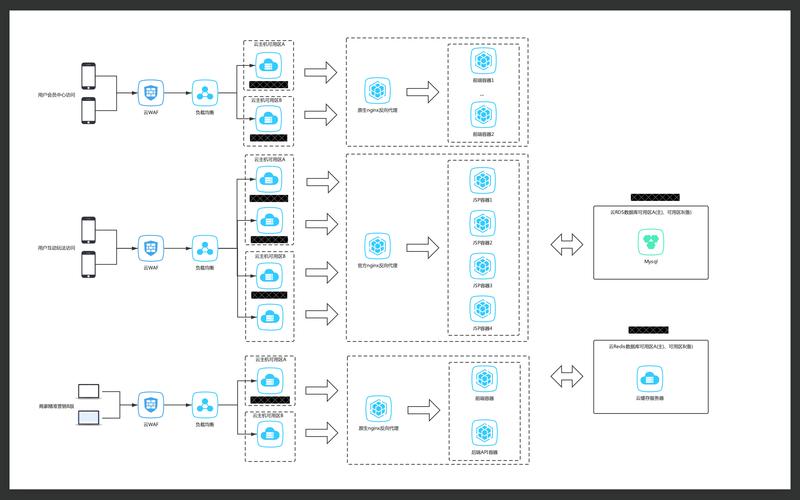 云计算平台预测性弹性伸缩架构图
说实话,论文里那些完美的曲线,拿到真实环境都得打折。但就是这个‘打折’的过程,才最见功力——你得理解业务,理解人的习惯。比如电商大促,那波峰几乎是可预测的,但偶尔有那种因为薅羊毛导致的畸形流量,模型根本没见过。这时候人工干预的入口就很重要,不能全自动。
容器编排的‘黑魔法’
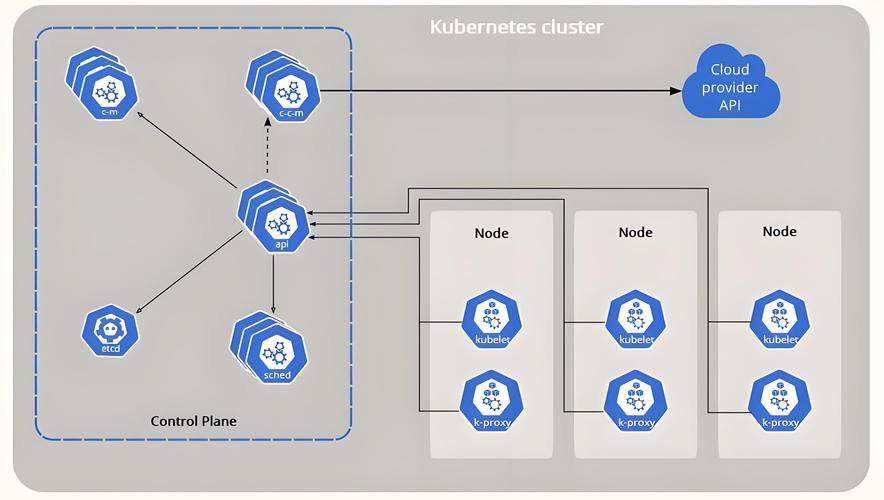 容器编排的‘黑魔法’
Kubernetes 调度器,啧啧。默认的调度策略就是一堆过滤器加打分,什么 LeastRequestedPriority,BalancedResourceAllocation,太老实了!它不知道你的业务有亲缘性,不知道有些服务就是‘话痨’,互相之间通信量巨大。我们做的一个科研成果是把图计算和网络拓扑感知加到调度器里。简单说,就是给调度器一副‘眼镜’,让它能看见服务间的依赖热度。实验的时候,跨节点通信开销直接砍掉30%,激动得我半夜在空荡荡的实验室里喊了一声——结果把保安招来了。
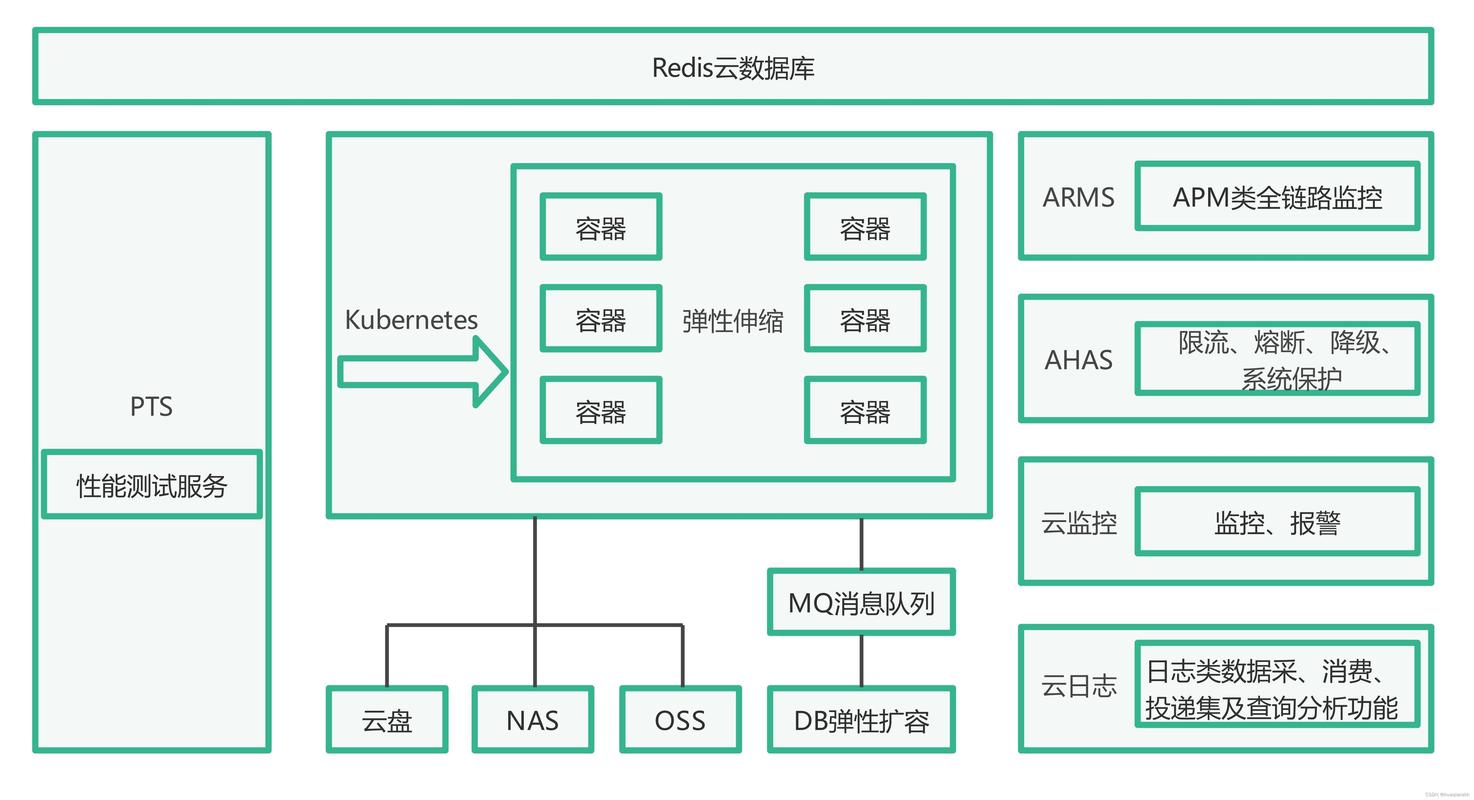 云原生微服务依赖拓扑图与调度优化
但落地时又一堆问题。真实集群里,节点状态瞬息万变,图计算的开销不能影响调度延迟。我们最后采用了增量学习的方式,只更新变化的部分,还引入了近似算法,把计算量控制在毫秒级。这才敢往生产推。不过话说回来,现在的调度器改得再牛,碰上那种申请8核实际用0.5核的‘占着茅坑’应用,还是没辙。所以右侧的垂直伸缩、资源推荐,得一起跟上。
从实验室到生产,那一步之遥
我至今记得那天,把打磨了半年的调度算法灰度上线。整个团队像等高考成绩一样盯着仪表盘。第一个小时一切正常,集群利用率蹭蹭上涨。然后开始出怪问题:有些短生命周期的批处理任务,因为调度器决策时间微妙拉长,结果误了执行窗口,连环失败。我们赶紧排查,发现是图形数据结构的序列化环节在高并发下有锁竞争。在实验室的小规模集群里根本暴露不出来!后来通过无锁数据结构和本地缓存才解决了。那几天压力大到爆痘,但修复后看着数据中心资源成本下降25%的报表,又觉得一切都值了。
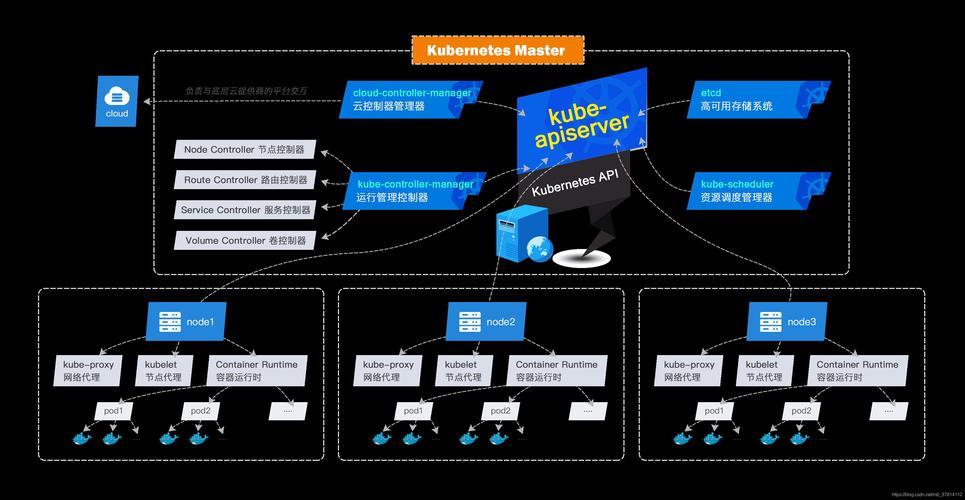 云计算平台大规模集群调度性能优化
很多人问我,搞云计算平台,到底是科研难还是工程难?我说,难的是把科研那句‘在某些假设下’变成‘在任何情况下’。这些年行业里的趋势也很明显,从AWS的Firecracker到Google的Borg,大家不都在追求更极致的隔离和效率吗?但我不觉得这是卷,这是真实的需求在推着走。毕竟每一点平台能力的提升,落到业务那边就是真金白银和用户体验。
最后说句心里话:构建云计算平台,别指望有银弹。就是不断地掉坑、爬坑、填坑,然后把填坑的经验变成自动化,算是给自己留的‘遗产’吧。如果你也在这条路上,握个手,咱们接着趟雷去。